我们从矩阵的角度来更泛化地讨论一下线性回归模型。我们先举一个关于多重线性回归的具体例子。如果我们想要研究教育和工作年限对于时薪的作用,我们建立一个线性模型:wage=β0+β1educ+β2exper+u。其中响应变量是工资(wage),预测变量是教育(educ),工作年限(exper)。回归系数是:β0,β1,β2,噪音变量是:u。
导论
我们从更严谨的角度来定义多重线性回归。响应变量是:Y;预测变量是:X1∗(p+1)=(1,X1,...,Xp);回归系数是β(p+1)∗1=(β0,β1,...,βp)T;噪音变量是:ϵ。模型是:Y=Xβ+ϵ。其中系数βi的意义是,在其他变量保持不变的情况下,βi可以衡量相对于Xi变化Y的变化。然而现实中,我们并不能真正严格保持其他变量不变来观察单个预测变量的灵敏度。
数据上看,假设样本数量是n,预测变量有p个。那么模型可以写成:Yi=β0+β1Xi,1+...+βpXi,p+ϵ,i=1,...,n。每个样本中的预测变量是:X(i)=(1,Xi,1,...,Xi,p);回归系数是:β(p+1)∗1=(β0,β1,...,βp)T;如此模型便是:Y=X(i)β+ϵ,i=1,...,n。我们将模型向量化之后,响应向量是:Yn∗1=(Y1,...,Yn)T;设计矩阵是:Xn∗(p+1)=(X(1),...,X(n))T=(1,X1,...,Xp);噪音向量是:ϵn∗1=(ϵ1,...,ϵn)T。那么之前的模型可以转化成:Yn∗1=Xn∗(p+1)β(p+1)∗1+ϵn∗1。
最小二乘估计
最小二乘估计指的是通过最小化残差平方和来估计回归系数β,β^=argminβ∑i=1n(Yi−X(i)β)2。用矩阵形式来表示,β^=argminβ∣∣y−Xβ∣∣2。这等价于最小化y和Xβ差的L2范式。我们对上述公式求一阶导数并使之为零来求取最小二乘估计值。一阶导数为零的条件是:XT(y−Xβ^)=0。当可逆XTX时,β^的最小二乘估计是β^=(XTX)−1XTy。
在得到系数的最小二乘估计后,多重线性回归模型的拟合值为:y^=Xβ^。残差为:ϵ^=y−y^=y−Xβ^。我们回到之前对于回归系数的讨论,假设r^j是Xj回归到X0,X1,...,Xj−1,Xj+1,...,Xp上的最小二乘残差,则β^j可以表示为β^j=r^jTr^jr^jy,即y对于r^j的无截距项的简单线性回归的参数估计。β^j表征着将X0,X1,...,Xj−1,Xj+1,...,Xp剔除后的Xj对于y的影响。
举个例子,假定模型Y=X+Z+ϵ,其中X,Z,ϵ各自相互独立。再假设我们观察到两个预测变量X1=X和X2=X−Z。如果我们将Y回归到X2上,我们得到的回归系数很可能是0。如果我们将Y回归到X1和X2上,我们将得到Y≈X+Z=2X1−X2,X2的系数是-1。下面来看看如何用“”剔除“”来解读-1这一回归系数:我们将X2回归到X1上,此时的残差为−Z。我们再将Y回归到残差−Z上,我们同样得到了-1的系数。在这个例子中,多重线性回归的系数体现了剔除掉X1后X2对于Y的影响,也即潜变量Z的影响。
之前提到,最小二乘的一阶导数为零的条件XT(y−Xβ^)=0,于是我们有XTϵ^=0。展开此公式,我们得到残差hatepsilon的下列性质
- 1Tϵ^=0因此yˉ=y^ˉ
- 当i=1,..,p,Xiϵ^=0。预测变量Xi与残差ϵ^的样本协方差为零。
- yˉ=(1,Xˉ1,..,Xˉp)β^
我们可以通过线性回归模型的几何意义来理解预测变量,拟合值与残差的关系。
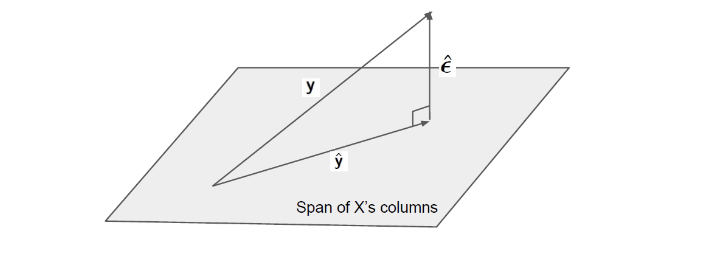
由图所示,线性回归实际上就是把响应变量y以残差最小的方式投影到预测变量X张成的子空间上,y^=X(XTX)−1XTy。我们知道矩阵的本质是作线性变换(投影),此时的投影矩阵是:H=X(XTX)−1XT。投影矩阵的性质有HH=H以及H(1−H)=0。我们可以将拟合值定义为y^=Hy,残差定义为ϵ^=(1−H)y,他们满足y=haty+hatepsilon和hatyperphatepsilon。
再来看看用来衡量拟合程度的R方,由于y^−yˉ1⊥ϵ^,因而∣∣y−yˉ1∣∣2=∣∣y^−yˉ1∣∣2+∣∣ϵ^∣∣2,也可表示成SST=SSE+SSR。R方的定义是:R2=SSTSSE=1−SSTSSR。我们可以论证R方是y−yˉ1和y^−yˉ1的样本相关系数的平方。要注意的是在额外加入任何预测变量后回归模型的R方都会只增不减。R方可以衡量整个模型的拟合程度,但无法决定单个预测变量的重要性。
重温一下在线性回归模型中使用最小二乘估计的几大假设:
- 参数的线性性,模型Y=β0+β1X1+...+βpXp+ϵ是参数β0,β1,...,βp的线性组合(注意模型不一定是预测变量的线性组合)
- 随机取样性,i=1,...,n观测值(X(i),yi)是某个概率模型中独立同分布的样本
- 预测变量间不存在完全的多重共线性,即Xi与剩余预测变量间不会正好线性相关。
- 残差的条件期望为零E[ϵ∣X1,...,Xp]=0。也就是说,对于的样本i=1,...,n,E[ϵ∣x1,...,xp]=0,或者用矩阵形式表示E[ϵ∣X]=0。
在满足了上述假设后,E(β^)=β,也就是说参数的最小二乘估计量是无偏的。
再追加一条关于最小二乘估计的方差的假设
- 同方差性,噪音变量ϵ在给定预测变量的条件下有相同的方差。Var(ϵi∣x1,...,xp)=σ2,i=1,...,n。矩阵形式表示为Cov(ϵ∣X)=σ2I。
在满足了上面所有假设后,在预测变量的样本值给定条件下,最小二乘估计的样本方差是Cov(β^∣X)=σ2(XTX)−1。
对于每一个系数估计的方差,我们可以得到Var(β^j∣X)=SSTj(1−Rj2)σ2=SSRjσ2,其中SSTj=∣∣Xj−Xˉj∣∣2是预测变量Xj的样本总方差,Rj2是将Xj回归到其他所有预测变量的R方,SSRj是将Xj回归到其他所有预测变量的残差平方和。
下面谈谈多重共线性,假定有两个完全一样的预测变量X1和X2。由于(β^1+c)X1+(β^2−c)X2=β^1X1+β^2X2,最小二乘法没有唯一解。退一步假定X1和X2几乎一样,X2=X1+ω。那么[(β^1+c)X1+(β^2−c)X2]−[β^1X1+β^2X2]=−cω。c的估计值由噪音ω决定,从而导致系数β^1和β^2估计的高方差。
多重共线性的精确定义是:存在j使得预测变量Xj能被表示成其他预测变量的线性组合,导致XTX不满秩而无法求逆。β^的最小二乘估计没有唯一解。我们一般提到多重共线性是指两个或多个预测变量之间相关系数较高。因为相关系数较高,则该预测变量对应的Rj2→1,因此Var(β^j∣X)=SSTj(1−Rj2)σ2→∞。我们可以利用方差扩大因子(VIF):VIFj=1/(1−Rj2)来检测多重共线性。VIF值较高则意味着变量间潜在的多重共线性。
利用残差ϵ^,我们可以估计σ2为σ^2=n−p−1∣∣ϵ^∣∣2=n−p−1SSR。其中估计量的自由度是n−p−1,也即观测值的数目减去参数数目。我们可以从几何意义上来理解,因为残差ϵ^正交与X张成的子空间,所以残差的子空间维度是n−p−1(总的空间维度是n)。这里σ2的残差估计是无偏的,即E[σ^2]=σ2。而参数估计的标准差是,Sd(β^j)=(SSTj(1−Rj2))1/2σ^。
偏差方差权衡是一个在机器学习领域很常见的话题,但它其实是一个统计概念。假设我们有一个真实的回归模型:Y=β0+β1X1+β2X2+ϵ。我们考虑系数β1的两种估计。第一种β^1来自真实的多重线性回归Y^=β^0+β^1X1+β^2X2;第二种β~1来自错误的回归(未囊括预测变量)Y~=β~0+β~1X1。对于这两种估计的偏差,我们有Bias(β^1)=0,Bias(β~1)=Var(X1)Cov(X1,X2)β2。而对于这两种估计的方差,我们有Var(β^1)=SST1(1−R12)σ2,Var(β~1)=SST1σ2。因此我们发现,Bias(β~1)2≥Bias(β^1)2,Var(β~1)≤Var(β^1)。错误的回归模型并非一无是处,只是在偏差方差的权衡中偏向了方差而已。
偏差方差权衡来源于这样一个问题,我们究竟如何衡量参数估计β^的准确性?我们有E[(β^−β)2]=Bias(β^)2+Var(β^),而最小化这一表达式需要在偏差与方差做出权衡。在之前的例子中,真实模型给出的β^1是无偏的但却有更大的方差,错误模型给出的β~1有偏差但方差更小。一般情况下引入更多预测变量会减小模型的偏差但会增加模型的方差。让模型囊括所有相关的预测变量并不总是有利的,我们还需要做变量筛选。
高斯马尔可夫定理论证了最小二乘估计的有效性,在之前提到的经典线性回归的假定下,最小二乘估计量是具有最小方差的线性无偏估计量(BLUE)。我们将BLUE拆开看:
- 线性:β^=(XTX)−1XTy,β~=Cy是响应变量观测值y的线性组合,其中C取决于预测变量的观测值。
- (最好的)无偏:对于任何无偏的估计量β~,E∣∣β~−β∣∣2=Cov(β~)。而“最好的”无偏估计β^拥有最小的方差,严格意义上,对于任何其他无偏估计量,Cov(β~)−Cov(β^)是半正定的。
- 最小方差:当j=0,...,p,Var(β^j)≤Var(β~j)。
推断
回到导论中提到的多重线性回归模型yn∗1=Xn∗(p+1)β(p+1)∗1+ϵn∗1,我们追加一条对于残差项的正态分布假设ϵi∣X∼N(0,σ2),或者用矩阵形式表示ϵ∣X∼N(0,σ2In)。因为响应变量的波动性全部来自于残差变量的波动性,因为正态分布假设等同于y∣X∼N(Xβ,σ2In)。
我们知道参数的最小二乘估计β^=(XTX)−1XTy,那么在正态分布假设下,β^∼N(β,σ2(XTX)−1)。对于每个参数βj,β^j∼N(βj,Var(β^j)),经过变换得到sd(β^j)β^j−βj∼N(0,1)。问题是我们不知道参数估计的真实标准差,但我们可以估计参数估计的标准差sd^(β^j)=(SSTj(1−Rj2))1/2σ^=σσ^sd(β^j),同时我们有σ2σ^2∼n−p−1χn−p−12。于是我们引入不包含任何未知变量的t统计量Tβ^j,Tβ^j=sd^(β^j)β^j−βj=σ^2/σ2(β^j−βj)/sd(β^j)∼χn−p−12/(n−p−1)N(0,1)。
t统计量Tβ^j服从自由度为的t分布Tβ^j∼tn−p−1。t分布长什么样呢?下图展示了t分布和正态分布的概率密度函数形状。
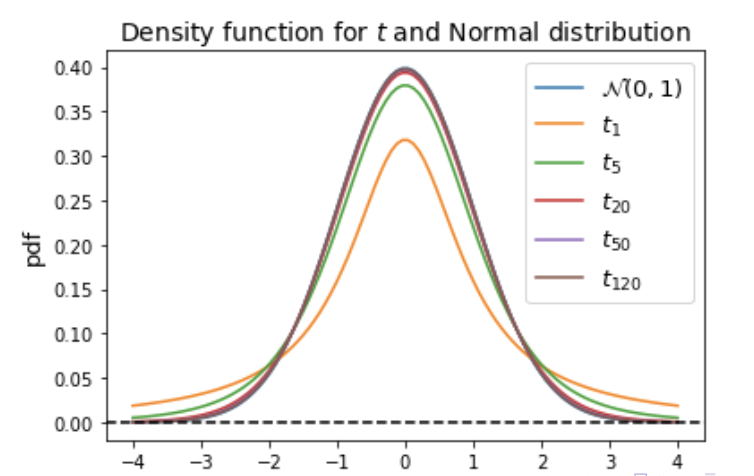
接下来谈谈单个参数的假设检验,也著名的t检验。其中零假设为H0:βj=0。锚定其他预测变量之后Xj与Y线性无关。t统计量Tβ^j=sd^(β^j)β^j∼tn−p−1。在5%的显著性水平下,当∣Tβ^j∣>tn−p−10.975拒绝零假设。P值定义为P(∣tn−p−1∣>∣Tβ^j∣),等价于说当p值小于5%时拒绝零假设。
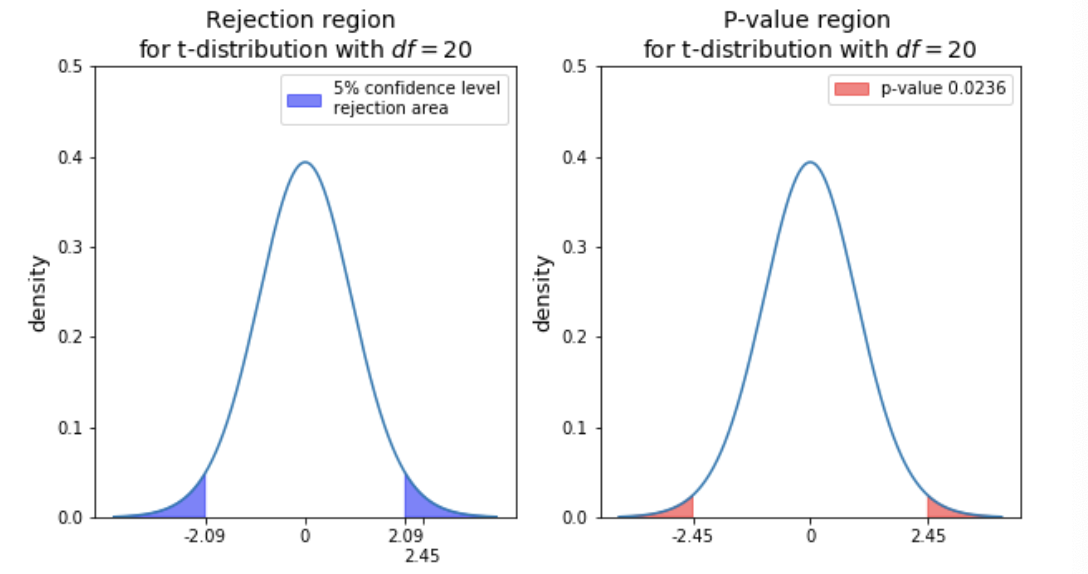
由于sd^(β^j)βj−β^j∼tn−p−1,对于未知参数βj,它的95%的置信区间为β^j±tn−p−10.975sd^(β^j)。有了参数的置信区间,我们可以进一步推导预测值的置信区间。对于一个新的测试样本(X0,y0),预测值y0=X0β^。易得s^e(y^0)y0−y^0∼tn−p−1,其中s^e(y^0)=σ^X0(XTX)−1X0T。那么y0的95%的置信区间是y^0±tn−p−10.975se^(y^0)。
F检测是用来检验多个参数的假设检验,其零假设时q个预测变量的系数同时为零,H0:βp−q+1=0,...,βp=0。我们假定完整的回归模型是:Y=β0+β1X1+...+βpXp+ϵ,有限的回归模型是:Y=β0+β1X1+...+βp−qXp−q+ϵ,那么从残差平方和的角度看,完整模型的SSRf<=有限模型的SSRr。
F统计量被定义为F=SSRf/(n−p−1)(SSRr−SSRf)/q。其中SSRr−SSRf代表了我们将要测试的q个预测变量能够解释的波动性。分子的自由度是q=dfr−dff,分母的自由度是n−p−1=dff,F统计量满足F分布,F∼Fq,n−p−1=χn−p−12/(n−p−1)χq2/q。对于F检测,当F>Fq,n−p−10.95我们拒绝零假设,P值为P(Fq.n−p−1>F)。
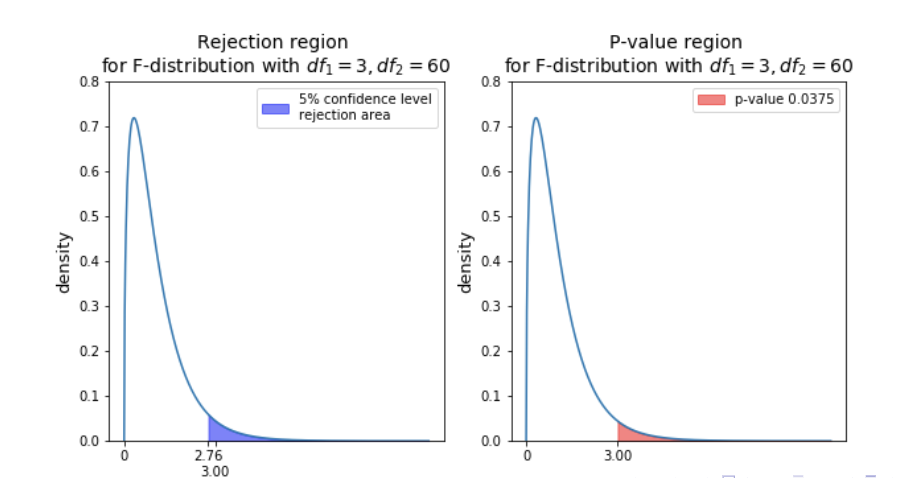
F检测通常被用来检测所有的预测变量是否同时与响应变量线性无关,也即q=p,H0:β1=β2=...=βp=0,此时F统计量是用于检测整个回归模型的显著性,F=(1−R2)/(n−p−1)R2/p。当q=1时,F检测和t检测在βj=0检测上是等价的。我们可以推导H0:βp=0 时,F=χn−p−12/(n−p−1)χ12=χn−p−12/(n−p−1)N(0,1)2=tβ^p2。
模型选择
为什么要进行模型选择呢?想象一下你手头有一千个预测变量,你会将他们一股脑放进你的线性回归模型吗?如果这么做了,一方面预测变量间会有多重共线性问题,另一方面即使他们相互独立,还是会因为囊括了无关的预测变量而造成模型过拟合问题,使得我们在偏差方差权衡中只关注减少偏差而产生极大的方差。因此我们需要选择出相互独立的且有预测效用的预测变量,这就是模型选择的动机。
预测变量的筛选准则是什么?换句话说我们要保证选出来的预测变量能够最优化某个模型选择的指标函数。这个筛选准则不能是残差平方和RSS或者R方,因为他们只会随着预测变量数目的增加而增加。我们需要同时考虑偏差和方差,通常我们考虑使用AIC(赤池信息量准则)和BIC(贝叶斯信息量准则)。两者非常相似,AIC=−2log(L^)+2p,其中L^是使用线性模型在当前参数估计下的似然函数值,而BIC=−2log(L^)+plog(n)。
有了准则,我们进行模型选择的一种策略就是搜索预测变量的全部子集,然后选择其中能够最小化AIC或BIC的那个集合。但全部子集的数量会随着预测变量数目而指数增长,p个预测变量会产生2p个子集。另一种策略是逐步变量选择,这种策略可以进一步划分为前向逐步回归和后向逐步回归,他们的思路近乎一致:
- 起始将预测变量的空集/全集构建回归模型
- 在每一次迭代中,加入/移除某一个预测变量,使得AIC或BIC能够最大程度的降低/升高。
- 当加入/移除任何一个预测变量都不能让AIC或BIC再降低/升高时停止
当然我们也可以在两个方向都进行逐步的搜索,即在每一次迭代中我们同时考虑加入和移除某个预测变量。我们可以看出这是一种类似“贪心算法”的策略。
除了对预测变量下功夫,我们也通过正则化模型来达到模型选择的效果。具体来说,岭回归和Lasso回归通过直接优化残差平方和+正则项来进行模型选择。
- 岭回归:PRSS=∑i=1n(yi−XiTβ)2+λ∣∣β∣∣2
- Lasso回归:PRSS=∑i=1n(yi−XiTβ)2+λ∣∣β∣∣
岭回归和Lasso回归看似近似却又不同。岭回归有着解析解:β^ridge=(XTX+λIp)−1XTy,而Lasso回归只能通过数值优化方法解出。两种回归方法都能有效处理多重共线性问题,区别在于岭回归不会将预测变量的系数缩减到零,但Lasso会将系数归零。假设我们有y=Xβ+ϵ,我们构建一个多重回归y=X1β1+X2β2+ϵ,其中X1,X2都是X附带一点小噪声(两者高度线性相关)。那么岭回归会将β1和β2都估计为β/2,而Lasso回归会将β1和β2其中一个估计为β,另一个为0。
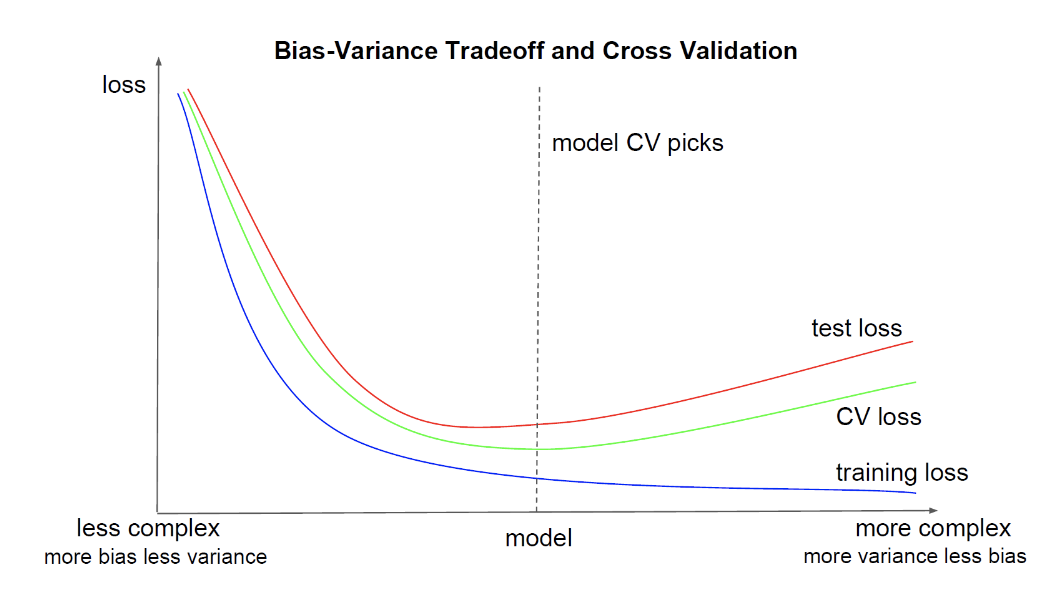
我们注意到岭回归和Lasso回归的模型中还有一个超参数λ,如何选取它的值呢?一个常用的办法是K折交叉验证:我们先将全部数据拆分成训练集T和测试集S,然后将训练集随机等分成K折,T=T1,...,TK。对于k=1,..,K和每个λ,使用除开 k折Tk之外的训练集拟合出模型,利用这个模型计算TK中数据的拟合值。对于每个λ的交叉验证整体误差为:CVErrorλ=∣T∣1∑i=1∣T∣(yi−y^iλ,CV)2。我们选取能让CVErrorλ最小化的那个λ∗。之后我们将λ∗带入整个训练集来拟合出模型,最后使用测试集S来衡量这个模型的有效性。
模型诊断
如果要对线性回归模型进行参数估计和推断,我们需要以下的假设:
- 线性关系
- 独立同分布的样本
- 残差服从均值为0,方差恒定的正态分布
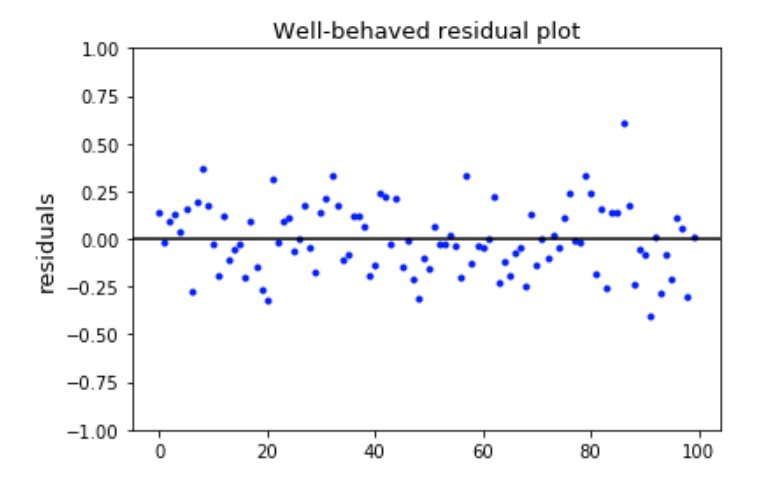
但我们如何从模型的结果判定这些假设是否都满足了呢?我们可以通过残差图来进行模型诊断。下图展示了良好的残差图,即样本是独立同分布,残差的均值为0方差恒定。
下图则是样本中存在异常值的残差图。
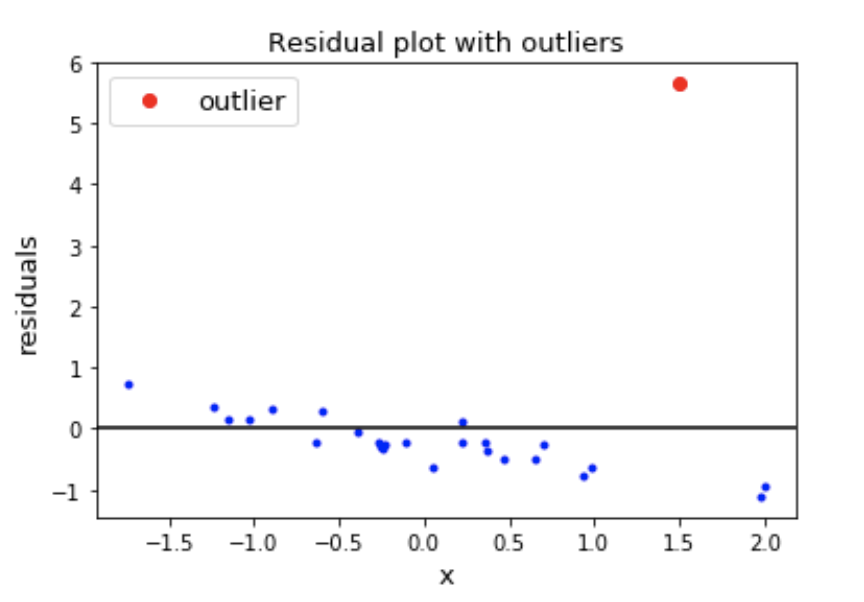
样本中为何存在异常值?这可能是数据收集是产生的错误,也可能是样本中包含了极端事件,又或是其他结构性的原因。当模型诊断出异常值后,我们可以直接去掉异常值,也可以削减异常值使其取值限于一定区间内,也可以单独为异常值来建模。
如果残差图显示了类似x2的非线性关系,我们可以将x2作为预测变量。
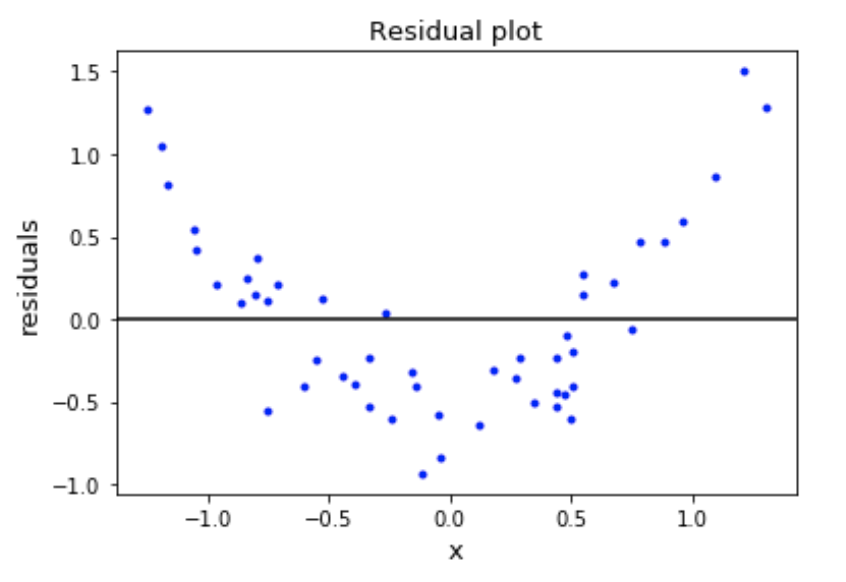
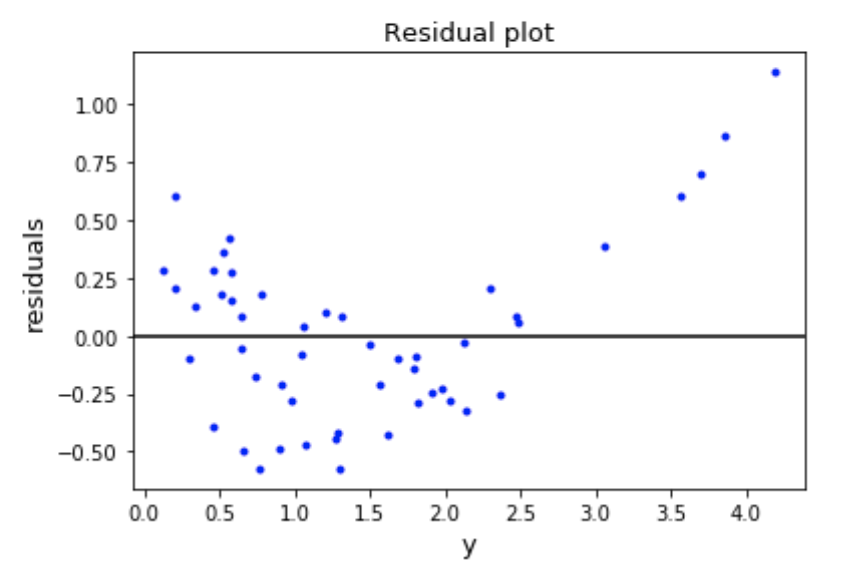
又如果残差图显示了类似ey的非线性关系,那么可以将log(y)而不是y作为响应变量。
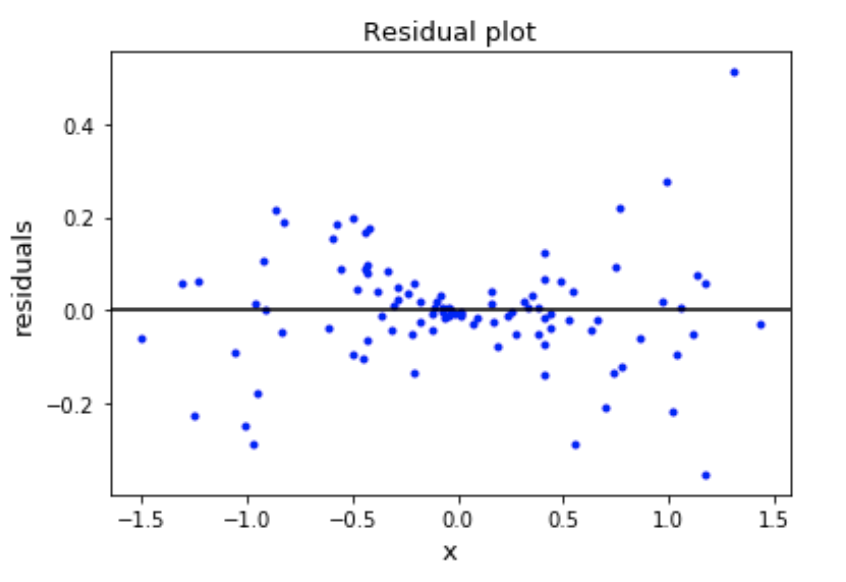
若残差随着∣x∣增长,意味着σ2(x)∼Cx2。此时我们可以使用加权线性回归。
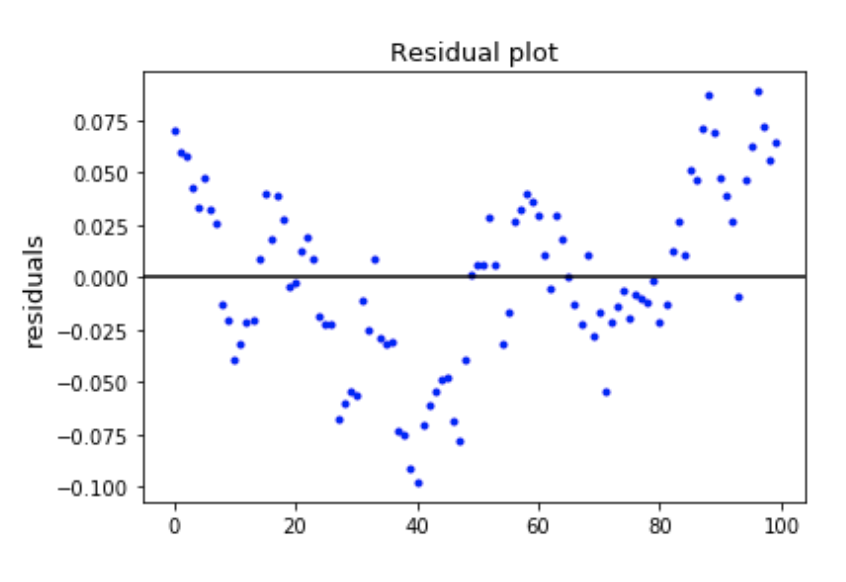
若残差有自相关关系,此时我们可以使用时间序列模型。
哑变量
首先我们需要知道分类变量,不同于数值变量,分类变量比如职业取值{0,1,2},来代表{学生,教授,医生}这些不同职业。哑变量与分类变量息息相关。假定分类变量X取值{0,1,..,q}代表q+1种类。我们可以将其变换成q个哑变量Z1,...,Zq,使得Zi是种类i的二元变量(0代表“基本”种类)
Zi={1,X=i0,otherwisei=1,...,q
原本的线性回归模型是Y=β0+...+βX+...,加入哑变量后Y=β0+...+(γ1Z1+...+γqZq)+...。γi表征属于种类i和属于“基本”种类0的区别,为什么不使用q+1个哑变量?因为这样会造成和截距项的共线性,基本种类的γ0其实已经包含在截距系数β0里了。
下面我们考虑分类变量之间的关系,假设我们有两个分类变量X1(q+1类)和X2(r+1类)。哑变量的相互关系可以用如下矩阵表示
Zij={1,X1=i,X2=j0,otherwisei=1,...,q,j=1,...,r
其中Zi.i=1,...,q表示q变量X1的边际效应,Z.jj=1,...,r表示r变量X2的边际效应
加权线性回归
为什么样本需要权重?因为样本的噪音(残差)有着不同的方差,我们需要给残差方差小的样本更高的权重。样本有不同价值或对应不同的损失函数值,我们需要给高价值低损失的样本更高的权重。有的样本因为种种原因自身有着更高的重要性,我们需要给重要的样本更高的权重。
加权线性回归模型对应的加权最小二乘法(WLS)损失函数为:∑i=1nwi(yi−Xiβ)2。如果我们根据残差方差进行加权,那么wi∼σi21。我们也可以使用样本价值,损失值或其他重要性指标来赋值wi。
用矩阵形式表示WLS损失函数为:(y−Xβ)TW(y−Xβ),其中W=diag(w1,...,wn)。WLS的解析解是β^WLS=(XTWX)−1XTWy,相比于OLS的解析解β^OLS=(XTX)−1XTy,多了这一项W。当样本残差相互关联时,W可以不是对角阵。此时损失函数变为(y−Xβ)TΣ−1(y−Xβ)。
