回归是一项随处可见的自然现象,人们最初开始关注回归正是从人类身高的遗传数据开始的。回归也是一种用于描述变量之间关系的统计模型,比如描述收入和食品支出关系的回归模型。回归更是一项预测未来资产价格和投资决策的有力的量化工具,比如人们曾经利用太阳耀斑数量来预测证券市场的收益(效果还不错)。
我们关注线性回归是因为可以利用它进行统计推断,细说起来就是可以
- 测试变量间是否存在线性关系(β=0?)
- 衡量变量间关系的不确定性(β的置信区间)
- 检测线性关系的假设和意外值
- 寻找针对自变量和因变量的合适的转化方式
人类身高数据与均值回归
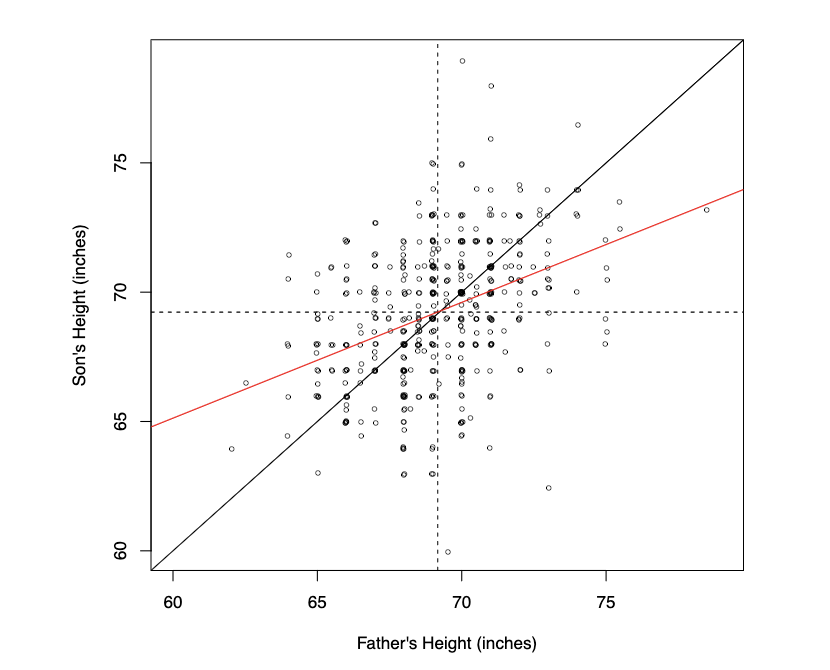
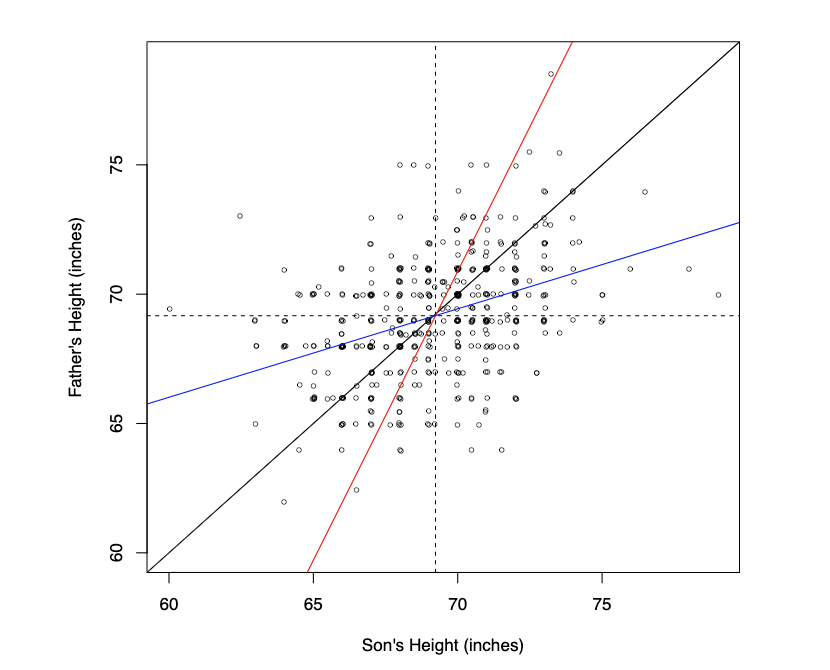
这两张图是Galton当时使用人类父子的身高数据所生成的散点图,我们可以看到不论选取儿子身高还是父亲身高去回归到另一组变量,最终形成的回归模型都是向均值靠拢的。
线性回归模型:变量,公式和推导
一个线性回归模型的变量包括:
- 随机变量Y:又称为响应变量,因变量,被预测变量,被解释变量,被回归量等。
- 变量X(不一定随机):又称为控制变量,自变量,预测变量,解释变量,回归量等。
我们需要(Y,X)的观测值(y1,x1),...,(yn,xn),是样本大小。如果X和Y只有一类变量可控,那么收集观测值的实验被称为控制实验,例如大豆产出和施肥量。如果X和Y两类变量均可控,那么回归模型可以进一步分为:描述性模型,例如收入vs食品支出;预测性模型,例如SPY明天的收益vs昨天的收益。
提到线性回归模型,一个简单(但错误的)的公式是:Y=α+βX+U,U∼N(0,σ2)。上述公式中需要被求取的是截距参数α和斜率参数β。这之中关键的假设是误差项U和X相互独立。
一个更精确的公式是:Y∣X=x∼N(α+βx,σ2)。其中概率密度函数是f(Y=y∣X=x)=2πσ1exp(−σ2(y−α−βx)2)。上述公式的简洁形式是:E(Y∣X)=α+βX。
当误差项满足之前公式所示的正态分布,使用最大似然估计(MLE)等同于使用最小二乘法(OLS)对线性回归模型进行估计。两者达成的目标都是最小化∑i=1nui2,其中误差项ui=yi−α−βxi。为了求取目标函数的最小值,我们将目标函数分别对截距参数α和斜率参数β求偏导,并令编导数同时为零。此时我们得到如下公式:
- ∑I=1nui=0→α^=yˉ−β^xˉ
- ∑I=1nxiui=0→拟合值y^i=α^+β^xi正交于ui
推导出线性回归模型的参数后,我们将得到误差项U=Y−E(Y∣X)→Cov(X,U)=0。这一关系成立的唯一假设是变量之间存在线性关系E(Y∣X)=α+βX,而对于误差项的分布没有任何要求。
我们常常对X和Y作中心化处理y~i=yi−yˉ,x~i=xi−xˉ,此时α^=0,这样对于求取回归模型更加容易,因为我们可以忽略截距项α。我们可以把斜率项β看成局部斜率的加权平均β^=∑i=1nx~i2∑i=1ny~ix~i=∑i=1n(∑i=1nx~i2x~i2)(x~iy~i)=∑i=1nwibi,其中权重wi正比于x~i2,同时∑i=1nwi=1。每一对观测值的局部斜率是:bi=x~iy~i=xi−xˉyi−yˉ。
虽然我们在估计α和β的期望时的唯一前提就是变量之间的线性关系,然而我们在衡量参数的期望估计的不确定性是需要额外假设。我们将这些假设总述如下
- 线性:E(U∣X)=0,U=Y−α−βX。反例是Y=X3,Y=eX。
- 随机取样:Yi在给定每个Xi下条件独立。反例是日照时长与温度的(时间序列)关系,或者Galton实验中多子女家庭的身高数据。
- 同方差性:Var(Y∣X)=Var(U∣X)=σ2。反例是收入与食品支出的关系。
- 正态性:Y在给定X下的条件分布是高斯(正态)分布。如果我们是随机地大量采样,且没有异常值的情况下一般样本是符合正态分布的(根据中心极限定理)。
依据上文的推导,β的最小二乘(OLS)估计是β^(Y1,...,Yn)=∑i=1n(Xi−Xˉ)2∑i=1n(Yi−Yˉ)(Xi−Xˉ)=∑i=1n(Xi−Xˉ)2∑i=1nYi(Xi−Xˉ)。这里公式左侧是基于自变量X的条件推断。而且我们假设Yi 是条件独立分布的且有着相同的条件方差σ2。β估计值的方差是Var(β^)=∑i=1n(Xi−Xˉ)2σ2=SSTXσ2,这里的条件方差(误差项方差)σ2=Var(Y∣X)是未知的。
我们知道误差项ui=Yi−α^−β^Xi,误差项方差σ2的最大似然估计(MLE)是σ^2=1/n∑i=1nui2=SSR/n。然而这个方差估计σ^2是有偏的,因为误差项ui满足两类限制∑I=1nui=0,∑I=1nxiui=0,我们在对其进行简单的线性回归分析自由度是n-2。误差项方差的无偏估计是σ^2=1/(n−2)∑i=1nui2=SSR/(n−2)。
将上述误差项方差估计带入β^的方差公式,我们得到β^标准误为s.e.(β^)=∑i=1n(Xi−Xˉ)σ~=n−21SSTXSSR。测试零假设H0:β=0的统计量为T=s.e.(β^)β^∼tn−2,T2=SSR/(n−2)SSE∼F1,n−2。95%的置信区间为[β^−Q∗s.e.(β^),β^+Q∗s.e.(β^)],其中Q=tn−2(1−.025)≈2。
拟合程度:R方和相关系数
最为人熟知的度量拟合程度的统计量就是R方:R2=SSE/SSTY=1−SSR/SSTY。其中SSTY=∑i=1n(yi−yˉ)2=∑i=1ny~i2,SSE=∑i=1n(y^i−yˉ)2=∑i=1n(β^x~i)2,而SSR=SSTY−SSE=∑i=1nui2=∑i=1n(y~i−β^x~i)2。R方的范围在0到1之间。
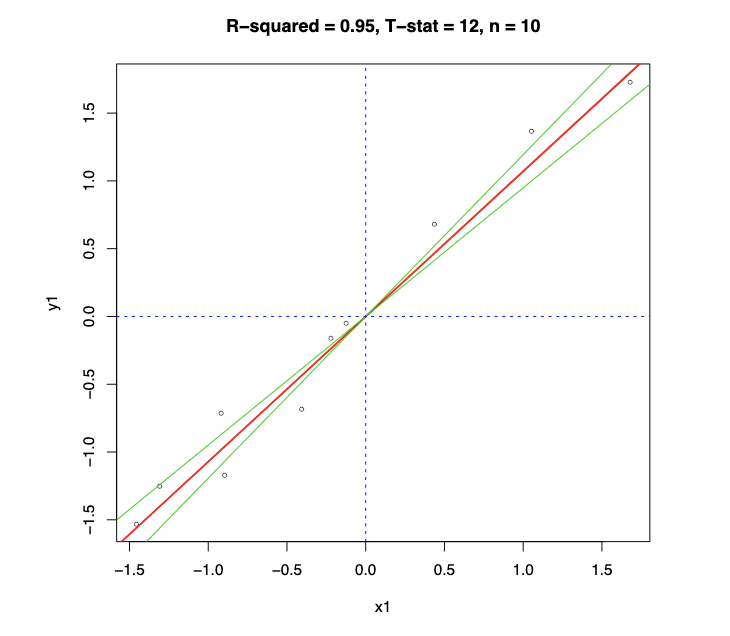
我们之前提到的β是否显著的T测试可以用来测试变量间的线性关系。T2=SSR/(n−2)SSE=(n−2)1−R2R2∼F1,n−2,s.e.(β^)=n−21SSTXSSR=SSTXSSTYn−21−R2。**我们发现斜率参数β的T统计量(平方)和R方之间只隔着样本数量这样一个乘数。**因此如下图所示,我们在观察T统计量时一定要考虑到样本数量的大小:
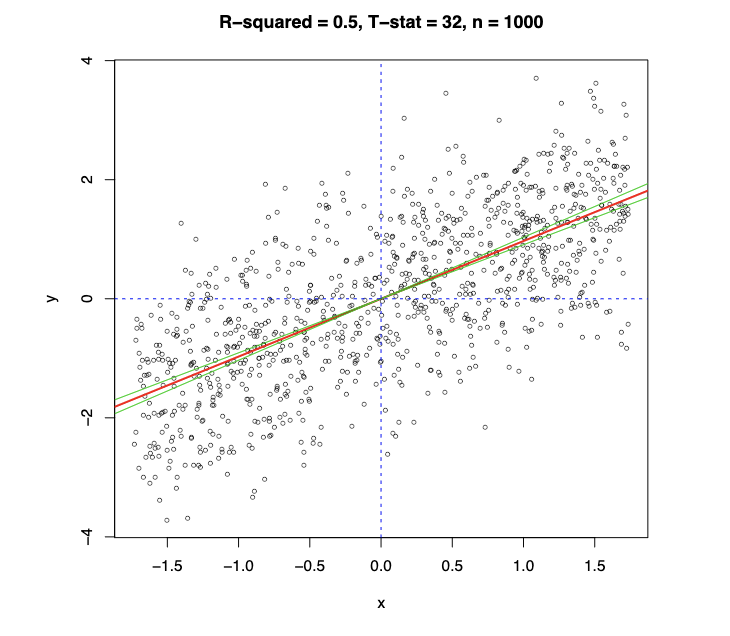
X与Y样本间的相关系数r也能用于衡量拟合程度,r=σ^xσ^y∑i=1ny~ix~i/n,其中σ^x2=1/n∑i=1nx~i2,σ^y2=1/n∑i=1ny~i2。而我们注意到R方其实就等于X和Y相关系数的平方R2=r2,两者在衡量线性关系时是等价的。
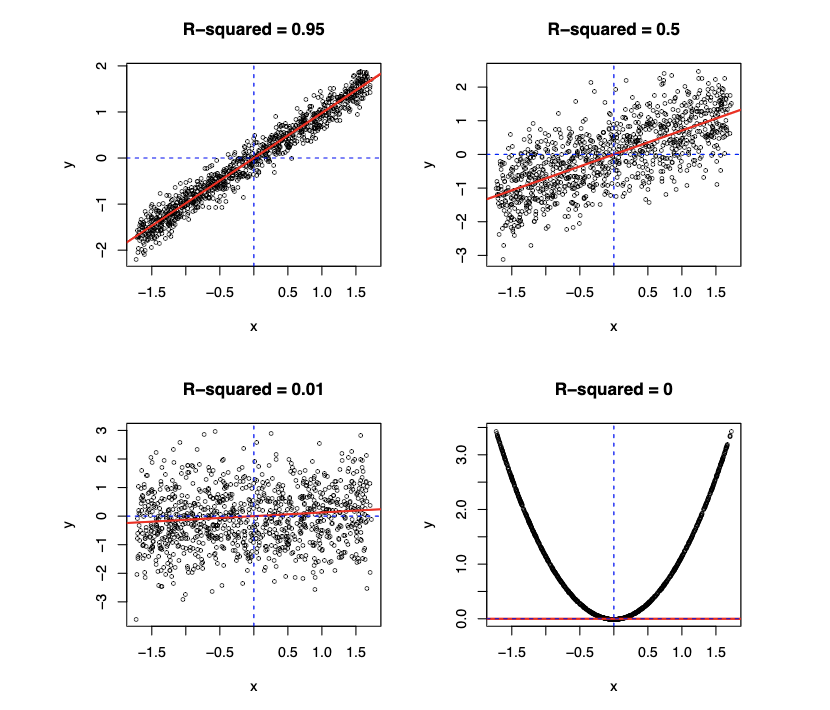
上述几张图是各种线性回归模型以及他们的R方。第一张图是描述物理现象的,第二张图是描述生物现象的,第三张图是关于金融市场建模的(其实已经是很不错的预测信号了),第四张图则不存在线性关系。
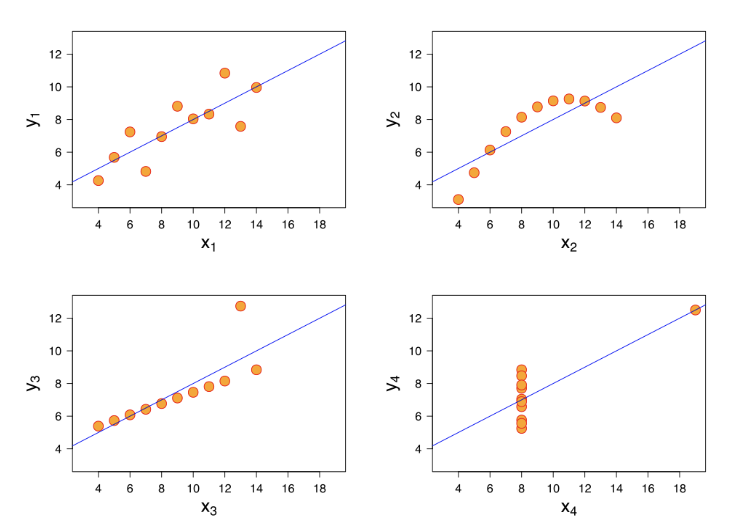
当然,仅凭R方,相关系数或T统计量并不足以衡量变量间的线性关系,著名的Anscombe四重奏就列举出了四个样本数量,均值,方差和相关性(包括R方,回归线,T统计量等)完全相同的数据集可以有多么不一样的实际样本。
模型诊断与变量转换
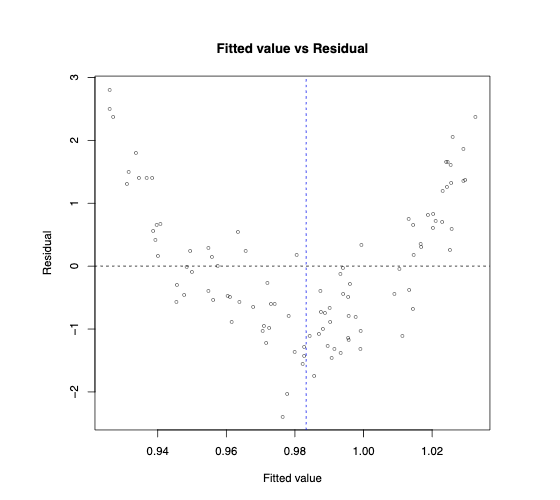
为了解决类似Anscombe的问题,我们通常诉诸于集中模型诊断图表。其中的代表是残差图和分位(Q-Q)图。残差图的横纵坐标分别表示拟合值Y^i=α^+β^Xi和残差ui=Yi−Y^i,可用于检测异常值,拟合结果的(非线性)模式,异方差性(残差的方差不恒定)。分位图可用于检测残差的正态分布(分布中是否有厚尾)。
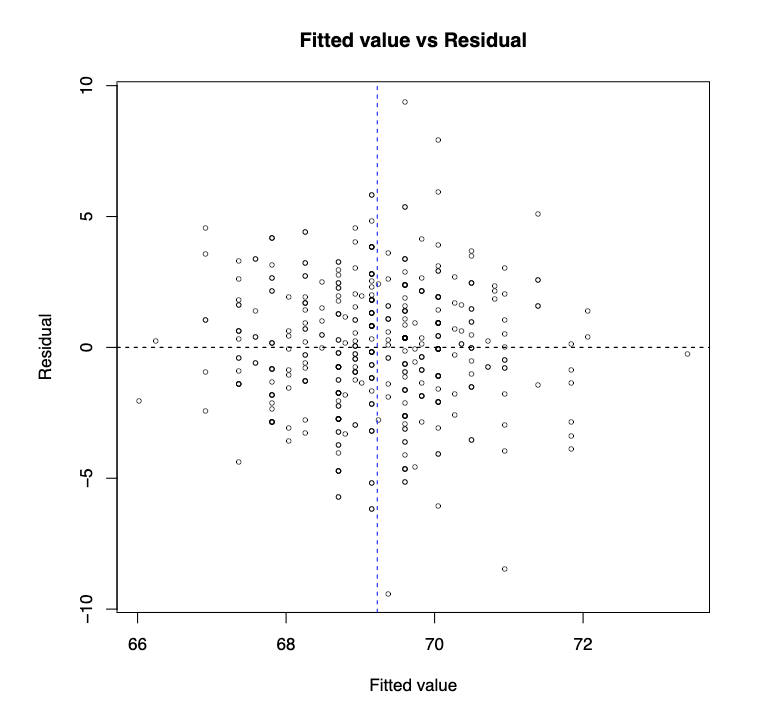
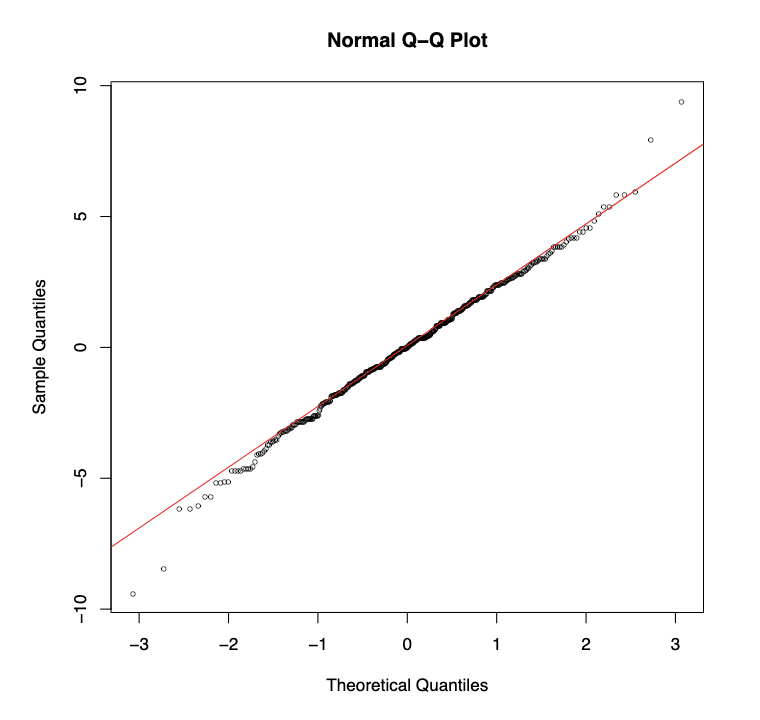
如果我们通过模型诊断图表发现异常值的话,我们可以去掉某个自变量或自变量的某个维度或特征(这在自变量维度越高的情况下影响越小),也可以去掉带来异常值的数据点(包括对应的应变量值,但我们必须多加谨慎)。
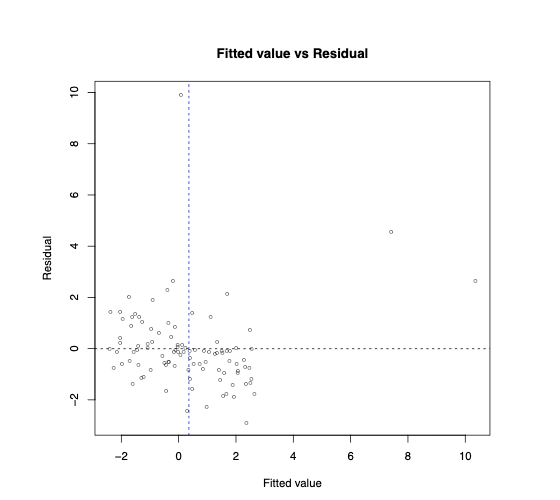
如果我们通过模型诊断图表发现非线性关系时,我们可以通过观察(Y的)直方图,将应变量作适当的转化。
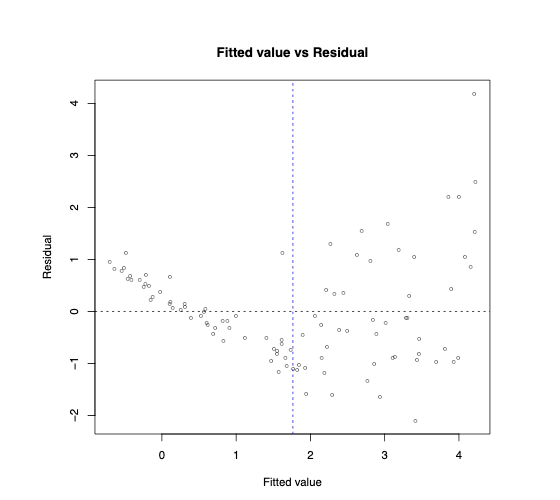
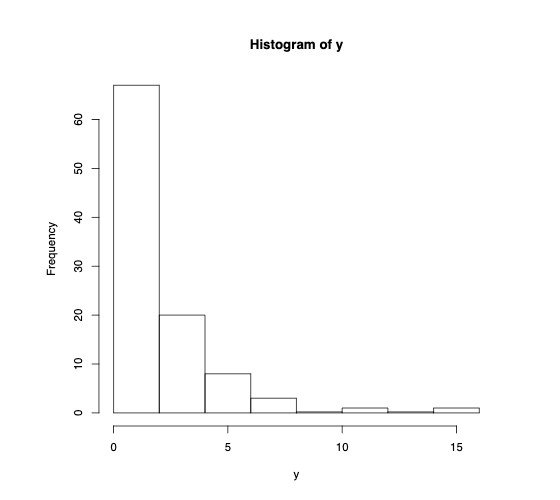
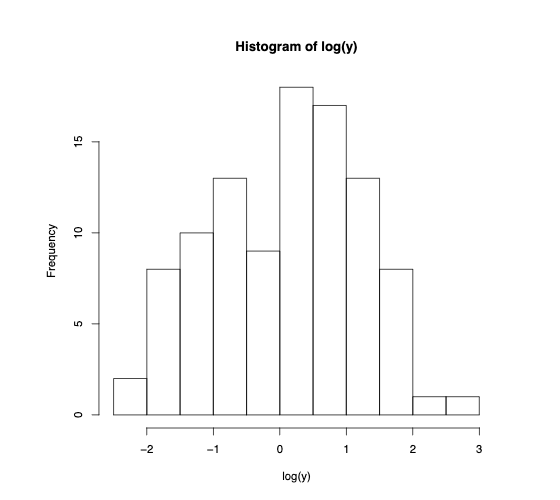
我们也可以对自变量作转化:使用包括离散化以及哑变量化;局部加权回归散点平滑法(LOESS);回归样条法(类似分段回归)等。
所谓哑变量也即自变量只能取0或1两个值。我们可以利用哑变量将自变量X分化成若干个区间。比如在回归模型中加入哑变量I(X≥0),Y=α+βI(X≥0)+U
分段回归指的是对于每个自变量取值区间用不同的回归线去拟合。Y=α1+β1X+U1,X<BP(breakpoint), Y=α2+β2X+U2,X≥BP(breakpoint),接下来的问题时如何选取breakpoints呢?
当模型诊断出异方差性时,我们可以使用加权最小二乘法化解。我们通常讲数据的权重设置为正比于 1/σi2(假如方差已知)。加权最小二乘法试图最小化目标函数∑i=1nwi(yi−α−βxi)2,wi=1/σ2,而其参数估计为β^w=∑iwi(xi−xˉw)2∑iwi(yi−yˉw)(xi−xˉw),以及α^w=yˉw−β^xˉw。其中yˉw=∑i(wiyi)/∑iwi,xˉw=∑i(wixi)/∑iwi。我们可以用非参数的方法(比如最近邻和核平滑法)来估计方差函数σi2=σ2(xi)。
一些例子
假设我们有一组观测值(xi,yi),其中xˉ=0,yˉ=0。我们将Y回归到X上:Y=αyx+βyxX+U。我们假定α^yx=0,β^yx=1,Ryx2=0.1。那么如果我们将X回归到Y上:X=αxy+βxyY+V。和直觉不同的是,此时α^yx=0,β^yx=0.1,Ryx2=0.1。
我们可以推导出β^yx与r的关系:β^yx=∑i=1nx~i2∑i=1ny~ix~i=σ^x2rσ^xσ^y=rσ^xσ^y。由此易得:β^yxβ^xy=r2=R2≤1,这个性质和Stein悖论直接相关。
假设我们有一组观测值(xi,yi),其中xˉ=0,yˉ=0。我们将Y回归到X上:Y=α+βX+U。我们假定α^=0,β^=1,R2=0.1,t−stat=2。如果我们将观测值重复使之加倍,此时根据公式α^=0,β^=1保持不变,而R2=r2=0.1也保持不变。但T统计量随样本量增加而变大,T2=(n−2)1−R2R2,T≈nR=22 。我们同时可以推导出原来的样本量,n=2+T2(1−R2)/R2=38。
在金融领域中,线性回归最常被用来来进行时间序列分析和横截面分析。假设我们有股票i在时间t时的价格序列Pt,i。我们定义股票i在时间t时的超前收益Tt,i,Yt,i=Pt,iPt+1,i−Pt,i≈log(Pt+1,i)−log(Pt,i)。我们同时有股票i在时间t时的预测值Xt,i(该值在时间t时已知)。横截面分析指的是在特定时间点t分析一系列股票数据。时间序列分析指的是在特定股票i上分析它的时序数据。面板分析则是指在不同股票不同时间点上分析数据。
截距项的意义
如果我们考虑一个面板回归E(Yt,i∣Xt,i=α+βXt,i),按照惯例我们通常会移除横截面Xt,i的平均值从而使得∑iXt,i=0。那么我们可以得到,α^=Yˉ。此时我们能否假设Yˉ=0?答案是可以,因为现实意义中我们可以使用市场中性收益作为应变量从而使得Yˉ=0,毕竟作为对冲基金我们能够“对冲”掉投资组合中的市场风险。当我们用市场中性收益Yt,i−Yˉt和横截面居中化的Xt,i−Xˉt做回归分析时,截距项就可以被忽略了,也即α=0。
回归权重和有效样本数目
调整回归权重的主要原因在于不同样本可能有着不同的经济学价值。比如不同州在大选中有不同的选举人数量,不同股票有不同的波动率和流动性,我们使用权重来刻画不同样本的“重要性”。
我们在前文提到过,已知一列权重向量[wi],加权最小二乘法最小化目标函数∑i=1nwi(yi−α−βxi)2,而其参数估计为β^w=∑iwi(xi−xˉw)2∑iwi(yi−yˉw)(xi−xˉw),以及α^w=yˉw−β^xˉw。其中yˉw=∑i(wiyi)/∑iwi,xˉw=∑i(wixi)/∑iwi。
有侧重的权重可以体现样本中不同的经济学价值,也会导致自变量的统计功效的降低。我们定义有效样本数目ESS=∑i=1nWi2(∑i=1nWi)2=σ22μw2≤n,注意到Var(Xi)=σ2,Var(Xˉ)=σ2/n,因此Var(Xˉw)=σ2/ESS≥Var(Xˉ)。
关于使用场景,简单来说我们会使用等权回归模型来估计参数,使用加权回归模型来计算预测值。
极值处理与稳定性
我们通常需要对自变量作转化处理来减小其极值带来的影响。比如裁剪掉某些自变量(这在自变量维度越高的情况下影响越小),使用横截面的排名(或百分位标准化值)来替代实际数值,移除极端值或裁剪掉对应的应变量值(但我们在运用清理后的回归模型进行预测时必须多加谨慎)。
我们在处理回归模型时总会面临效率性和稳定性的权衡。在极端情况下,我们只会在回归模型左侧使用应变量的正负号,同时我们仍然能得到无偏的估计值。此类过程取得了相当的稳定性,但在样本数量较小时不够有效率。
具体来说,若Y=βX+U,其中X∼N(0,σx2),U∼N(0,σ2)。我们用Z表示Y的(正负)符号,然后用Z对X作回归:Z=a+bX+V。参数估计量b^ 以及β 的关系是E(b^)=π2σYβ,其中σY2=β2σX2+σ2是Y的方差。同理我们也可从b^得到β的无偏估计。
残差化
假设我们在模型中加入一个新的预测变量Z到我们原先整合过的预测变量X,如何选取Z的系数呢?现在我们有多重线性回归模型Y=β1X+β2Z+U,其中关键的假设是随机误差U和X还有Z是线性不相关的。我们可以通过两步简单线性回归来估计β2,
- 将Z对X进行残差化,Z=γX+U1
- 将Y对残差U1=Z−γ^X作回归来得到β^2
现简略证明如下:我们对多重线性回归模型作适当变换Y=β1X+β2Z+U=(β1+β2γ^)X+β2(Z−γ^X)+U 而从最初的多重线性回归我们知道U⊥X,U⊥Z→U⊥(Z−γ^X), 由Z的残差化定义我们知道Z−γ^X=U1⊥X,因此我们得出Z−γ^X与(β1+β2γ^)X,U均线性无关,因此β^2正是Y对残差U1=Z−γ^X作回归之后的斜率系数。再进一步说,如果我们从回归模型Y=βX+U2中得到β^,那么β^1=β^−γ^β^2
贝叶斯回归与正则化
贝叶斯回归简单来说就是在线性回归Y=βX+U,U∼N(0,σ2)的基础上对参数加上一个先验分布β∼N(μ0,σ2/λ0)。β的后验分布是一个高斯分布,其期望是E(β∣Y,X,σ2,μ0,σ02)=∑iXi2+λ0∑iXi2β^OLS+∑iXi2+λ0λ0μ0,方差是Var(β∣Y,X,σ2,μ0,σ02)=∑iXi2+λ0σ2。当μ0=0时我们发现贝叶斯估计就等价于岭回归(也称Tikhonov回归)。
我们可以将贝叶斯回归理解成对于简单线性回归进行了某种正则化,正则化最小二乘法式图最小化(假定α=0):∑i=1n(Yi−βXi)2+λ0P(β),λ0>0。
- 当P(β)=β2时,我们得到了岭回归(β的先验为期望为0的高斯分布)。其中岭回归的参数估计β^ridge=∑iXi2+λ0∑iXi2β^OLS,这相当于将OLS的估计值β^“缩减”向零
- 当P(β)=∣β∣时,我们得到了套索回归(β的先验为拉普拉斯分布)。其中套索回归的参数估计β^lasso=max(0,β^OLS−λ0sign(β^OLS)),相当于∣β^OLS∣<λ0时为零,否则缩减向零。这也被称为软阈值。
那么如何选取先验分布的惩罚系数?一般我们是通过已有的经验,亦或是依据测试样本的表现从优选取(即交叉验证法)。我们为什么要使用正则化呢?这就要提到机器学习中常说的偏见方差权衡(尤其在样本数量小的情况下),同时我们希望取得更优异的样本外预测能力(尤其是当我们在研究多种预测变量时)。既然提到了样本外预测,我们接下来讨论一下斯坦因悖论(Stein’s paradox)。
斯坦因悖论
假如我们想要预测m个独立模型[θk,k=1,...,m]所产生的日收益,我们可以观察每个模型在n天里的收益并计算每个模型的日均收益Zk=θk+U,U∼N(0,σn2=σ2/n),那么我们能否用Zk来估计θk?
如果θk的估计值采用βZk的形式,那么β的最佳值是多少?当m=2时,β最佳值=1。当m>2时,我们需要最小化∑k=1m(θk−βZk)2,这其实就是将θk回归到Zk上。由前文的推导,当m=2时我们有β^∗1=R2<1,其中R2是θk回归到Zk的R方,当然我们无法实际测算出该R方,因为θk并不可被直接观测。
James和Stein在1961年提出以下β的估计值:β^JS=1−∑k=1mZk2(m−2)σn2<1,同时θ^JS=β^JSZk。Stein估计值的优越性是显而易见的,当m>2时,对于任意[θk,k=1,...,m],我们有E[∑k=1m(θk−β^JSZk)2]<E[∑k=1m(θk−Zk)2]。该估计值可以进一步优化为(0,β^JS)。
辛普森悖论和抽样偏差
辛普森悖论(Simpson‘s paradox)指的是在数据的不同部分中表现出的趋势在将它们整合后该趋势消失甚至反转的现象。
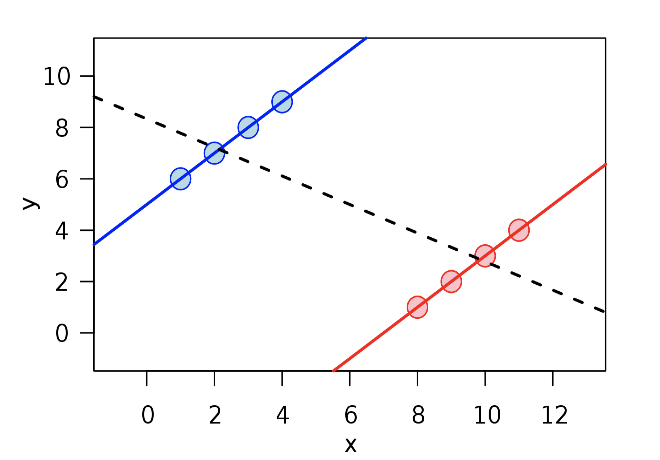
如果整合标记Z可以被观察到,我们可以对于不同部分的观察数据拟合出不同的模型,然后利用整合标记将不同模型组合成一个系数可变的模型Y=(β0+β1Z)X+U=β0X+β1ZX+U。其中,同时U与X,ZX相互独立。
如果整合标记是隐藏的且无法观测。我们可以对这一不可观测的标记进行建模,将其包装成一个混合模型中的隐藏(离散)随机变量或者随机效应模型中的连续隐藏变量。
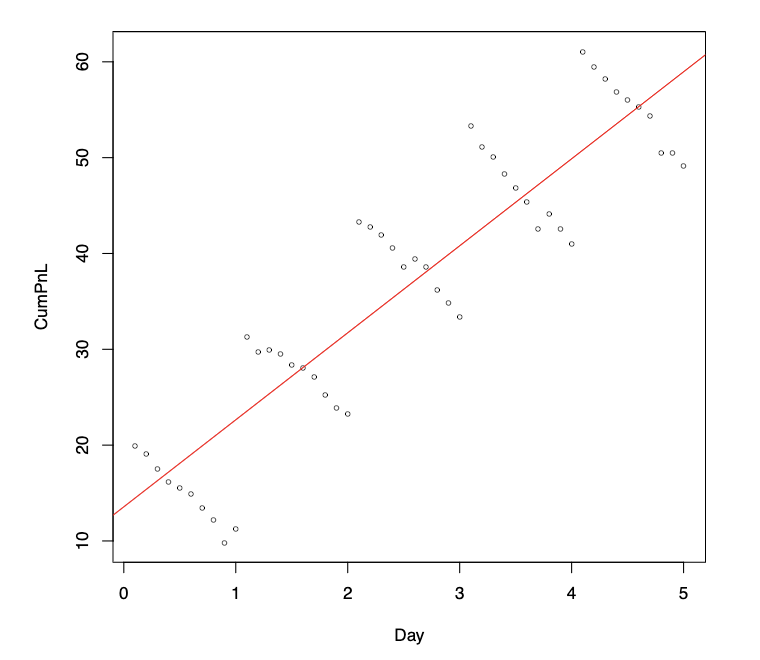
抽样偏差的问题也值得我们保持谨慎,我们必须对数据收集过程时时关注,提防诸如幸存者偏差,数据遗失这样的现象。
回归谬误
那么回到我们最开始提出的一个问题,为什么人类身高会出现“均值回归”的现象呢?这是因为人类不同代际间的身高数据的方差是相对恒定的:σ^x≈σ^y→β^≈r<1,那么将父子两组身高数据进行回归后,因变量相比于自变量会更收敛,所以我们得出的回归模型会向均值靠拢。如果β^=1,那么几代人之后我们会发现高大的人的后辈变得更加高大,矮小的人的后辈更加矮小,最终人类将分化为巨人和侏儒。
均值回归等类似现象引出的回归谬误其实比比皆是:
- 赞扬有时会反噬:是否有时批评比赞扬更有效?有时候优异的表现只是运气使然,过度赞扬只会让人们归因于不存在的实力或经验。
- NBA的“新秀墙”:比如当年的林疯狂Linsanity,其实只是新秀年的超常发挥后自然的均值回归。
- 在某个路段安装超速摄像头后事故频率降低了,因此超速摄像头有助于提升道路安全。其实也有可能是,这个路段之所以被撞上摄像头是因为之前一段时间的事故率非常高,而装上摄像头后路段的事故率自然下降到均值,和摄像头本身并无关系。
