概率与统计往往被人们混为一谈,但他们在历史中初次登场相隔甚远。概率第一次作为数学分支出现在帕斯卡与费马在1654年前后的通信讨论中。统计则晚了一百年左右在1761年由贝叶斯提出,在此之前统计往往被认为是“数字骗术“。到了如今,概率和统计风头正劲,充斥于数据科学和机器学习两大热门领域中。概率和统计有什么区别呢?概率假设我们已知某个随机过程,然后去解答”什么将会发生“的问题。而统计假设我们未知某个随机过程,仅仅通过一个观测值去解答”什么已然发生“的问题。
我们将先通过一些具体的例子来尽量严格地描述概率理论
掷硬币中的概率理论
掷硬币可以看作一个随机实验的实例, 我们通过这个实例来介绍样本空间,时间,和概率的概念。
掷一次硬币
- 样本空间:Ω={H,T}
- 事件:F={∅,{H},{T},{H,T}}
- 概率:P({H})=P({T})=0.5
掷两次及更多有限次硬币
- 样本空间:Ω={HH,HT,TH,TT}
- 事件:F={∅,{HH},{HT},...{HH,TT}...}
- 概率:P({HH})=P({HT})=P({TH})=P({TT})=0.25
掷有限无穷多次硬币
- 样本空间:Ω={HHHH...,TTTT...}
- 事件:F={∅,{H先于T出现},{HH先于TH出现},...}
- 概率:P({H先于T出现})=0.5,P({HH先于TH出现})=?
掷无限无穷多次硬币
抱歉, 我们不知道如何定义上述概念了,我们需要一些测度论的知识来完善理论体系。
在测度论的表述下:
- 样本空间:实验中所有可能结果的集合Ω
- 事件:Ω中满足一定条件(必须是σ域)的一系列子集构成的集合F
- 概率:一次随机试验中被包含在F 中的所有事件的可能性P,P是F上满足以下特性的一个实函数 :
- P(A)≥0 当 A∈F
- P(Ω)=1 且 P(∅)=0
- 如果 An∈F 是一系列相互独立的事件, 那么 P(∪nAn)=ΣnP(An)
除了样本空间,事件和概率三件套外,我们还需要进一步定义随机变量。理论定义下,随机变量X:Ω→E是一个从样本(概率)空间Ω到可测空间E的可测函数, 通常X为实函数。
离散随机变量
还是用掷硬币的例子
公平硬币
- 样本空间:Ω={H,T}
- 事件:F={∅,{H},{T},{H,T}}
- 概率:P({H})=P({T})=0.5
- 随机变量:X({H})=1,X({T})=0
通常情况(有限或无限)
- 样本空间:Ω={E1,E2,...En,...}
- 事件:F=Ω的所有子集
- 概率:P(Ei)=pi当pi≥0并且Σipi=1
- 随机变量:X(Ei)=xi
连续随机变量
到目前我们基本有了对于概率完备的定义。公理性定义的好处在于其抽象性,它能把不同情况下看似不同的事物置于同一框架下讨论,比如现在我们定义连续情形下的概率分布就自然而然多了。
连续分布
- 样本空间:Ω=R
- 事件:此时F并非Ω的所有子集!我们只能局限于一系列左开右闭的区间集合I={(−∞,x]∣x∈R}的σ域σ(l)
- 概率:P(X≤x)=F(x)也即累计分布函数(CDF)以及它的导数,概率密度函数p(x)=∂x∂F(x)
比如我们熟悉的正态分布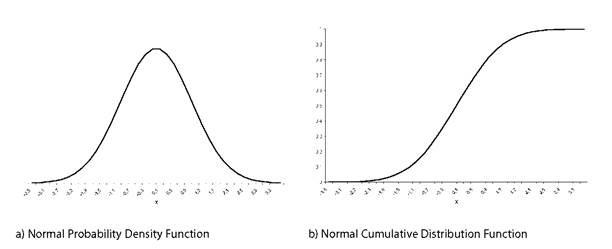
更进一步,如果我们将概率分布的定义扩展到双变量的情形:
离散情况
- 样本空间:Ω可以是任何二维集合(不一定需要是笛卡尔积)
- 事件:F=Ω的所有子集
- 概率:P(X=xi,Y=yj)=pi,j
连续情况
- 样本空间:Ω=R2
- 事件:此半闭的区间集合I={(−∞,x]∗(−∞,y]∣(x,y)∈R2}的σ域σ(l)
- 概率:P(X≤x,Y≤y)=FX,Y(x,y)=∫−∞x∫−∞ypx,y(u1,u2)du1du2
期望
既然我们定义了累计分布函数和概率密度函数,我们能从P(x)中得到什么有趣的结论呢?
- 尾部概率:p=P(X≥2)=∫2∞p(x)dx
- 平均值:μ=∫xx∗p(x)dx
- K阶矩:Mk=∫xxk∗p(x)dx
- K阶中心矩:κk=∫x(x−μ)k∗p(x)dx
- 方差:σ2=M2−μ2=κ2
- 偏态:σ3κ3
- 峰态:σ4κ4
这些都是为了引出期望的概念,而期望不过是平均值的另一种更酷的叫法。离散情形下E(X)=ΣixiP(X=xi),连续情形下E(X)=∫xxp(x)dx。
但期望在整个概率理论中是非常重要的,比如尾部概率可以写成p=P(X≥2)=E(l{X≥2}),K阶矩可以写成Mk=∫xxk∗p(x)dx=E(Xk),K阶中心矩可以写成κk=∫x(x−μ)k∗p(x)dx=E((X−μ)k)
期望可以是无穷的,也可以不存在。
期望有着线性特质,即E(aX)=aE(X), E(X+Y)=E(X)+E(Y),或者干脆写成 E(aX+bY)=aE(X)+bE(Y)
关于期望,还有一些高中数学知识所引出的知名不等式:
- E(X2)≥E(X)2
- Cauchy Shwarz: E(X2)E(Y2)≥E(XY)2
- AM-GM: logE(X)≥E(log(X)),当X>0
- Jensen: E(f(X))≥f(E(X)),当f(X)为凸函数
- Markov: P(X≥a)≤E(X)/a,X≥0, a>0
- Chebyshev: P(∣X−E(X)∣≥a)≤Var(X)/a2,a>0
独立(同分布)
有了期望,我们就能严谨地定义同分布的随机变量了,如果两个随机变量同分布,即X1∼X2,P(X1≤x)=P(X2≤x),那么我们假定期望满足
- E(X1)=E(X2)
- E(f(X1))=E(f(X2))
独立同分布的随机变量X1,X2,...Xn,...,同分布意味着他们全部满足相同的分布Xi∼F(X),独立意味着他们的分布Xi是相互独立的。
如何理解这里的独立?独立说明了解X并不能告诉我们关于Y的任何信息(好似一个完全过拟合的模型)。严格的定义下:
- 离散情况:P(X=x,Y=y)=P(X=x)P(Y=y)
- 连续情况:P(X≤x,Y≤y)=P(X≤x)P(Y≤y) 或者 p(x,y)=p(x)p(y)
独立是很有用的一个概念,因为独立假设成立时边缘分布决定了联合分布;独立构成了投资组合分散化的理论基础,即Var(nΣi=1nXi)=Var(X1)/n当Xi独立同分布时;大部分统计模型中是假设样本是独立抽取的。
其实在我们印象中,独立是和期望紧密结合的,比如:
E(XY)=E(X)E(Y)当XY独立且他们的期望存在时
关于这条性质的大略证明:
- E(l{X∈A})=P(X∈A)
- E(l{X∈A}l{Y∈B})=E(l{X∈A}∩l{Y∈B})=P((X∈A)∩(Y∈B))
- P((X∈A)∩(Y∈B))=P(X∈A)P(Y∈B)
- E(l{X∈A}l{Y∈B})=E(l{X∈A})E(l{Y∈B})
进一步拓展这个性质,当我们有f,g两个函数时,E(f(X)g(Y))=E(f(X))E(g(Y))
结合独立同分布和期望,就能引出如下两个概率理论中耳熟能详的定理:
- 大数定理:Xˉn=nΣiXi→E(X),当Xi独立同分布且期望有限时
- 中心极限定理: σn(Xˉn−μ)→N(0,1),当X_i独立同分布且期望与方差有限时
统计意义下
- 大数定理:样本均值与总体均值一致
- 中心极限定理: 样本均值与总体均值的差距符合一个N(0,σ2/n)的正态分布
正是由于期望,独立和条件概率的出现,才使概率与纯测度论成了数学的两个分支。许多统计模型都是要解决像E(Y∣X)和Var(Y∣X)这样的条件概率问题,最突出的例子就是线性回归模型。
条件概率
如果两个变量不是相互独立的,那么他们将会有依赖关系,条件概率正是用来描述这种依赖关系。离散情形下,条件概率比较直观的定义是P(Y=y∣X=x)=P(X=x)P(Y=y∩X=x),如果两个随机变量满足相互独立的情况,则P(Y=y∣X=x)=P(Y=y)
连续情形下定义条件概率会复杂一些
- 因为我们将会遇到0/0困境:P(Y=y∩X=x)=P(X=x)=0
- 解决方式1:利用条件累计分布函数P(Y≤y∣X=x) 或者他的导数,也即概率密度函数pY∣X(y∣x)=p(Y=y∣X=x)
- 解决方式2:当ϵ→0时,对P(Y≤y∣X∈[x−ϵ,x+ϵ])取极限
- 相互独立的情况:p(Y=y∣X=x)=p(Y=y)
当我们做统计推断时,我们往往是在推断一个变量关于另一个变量的条件概率,这就是条件概率的直接应用。我们来看一个关于条件概率产生的有趣例子:辛普森悖论
一所美国高校的两个学院,分别是法学院和商学院。新学期招生,人们怀疑这两个学院有性别歧视,现作如下统计:
|
申请人数 |
录取率 |
| 男生 |
304 |
68.8% |
| 女生 |
253 |
56.5% |
分学院统计如下:
|
男生 |
|
女生 |
|
|
申请人数 |
录取率 |
申请人数 |
录取率 |
| 法学院 |
53 |
15.1% |
152 |
33.6% |
| 商学院 |
251 |
80.1% |
101 |
91.1% |
根据上面两个表格来看,女生在两个学院都被优先录取,即女生的录取比率较高。可是在总评中,女生的录取比率反而比男生低。简单的将条件概率相加汇总,是不能反映真实概率分布情况的。
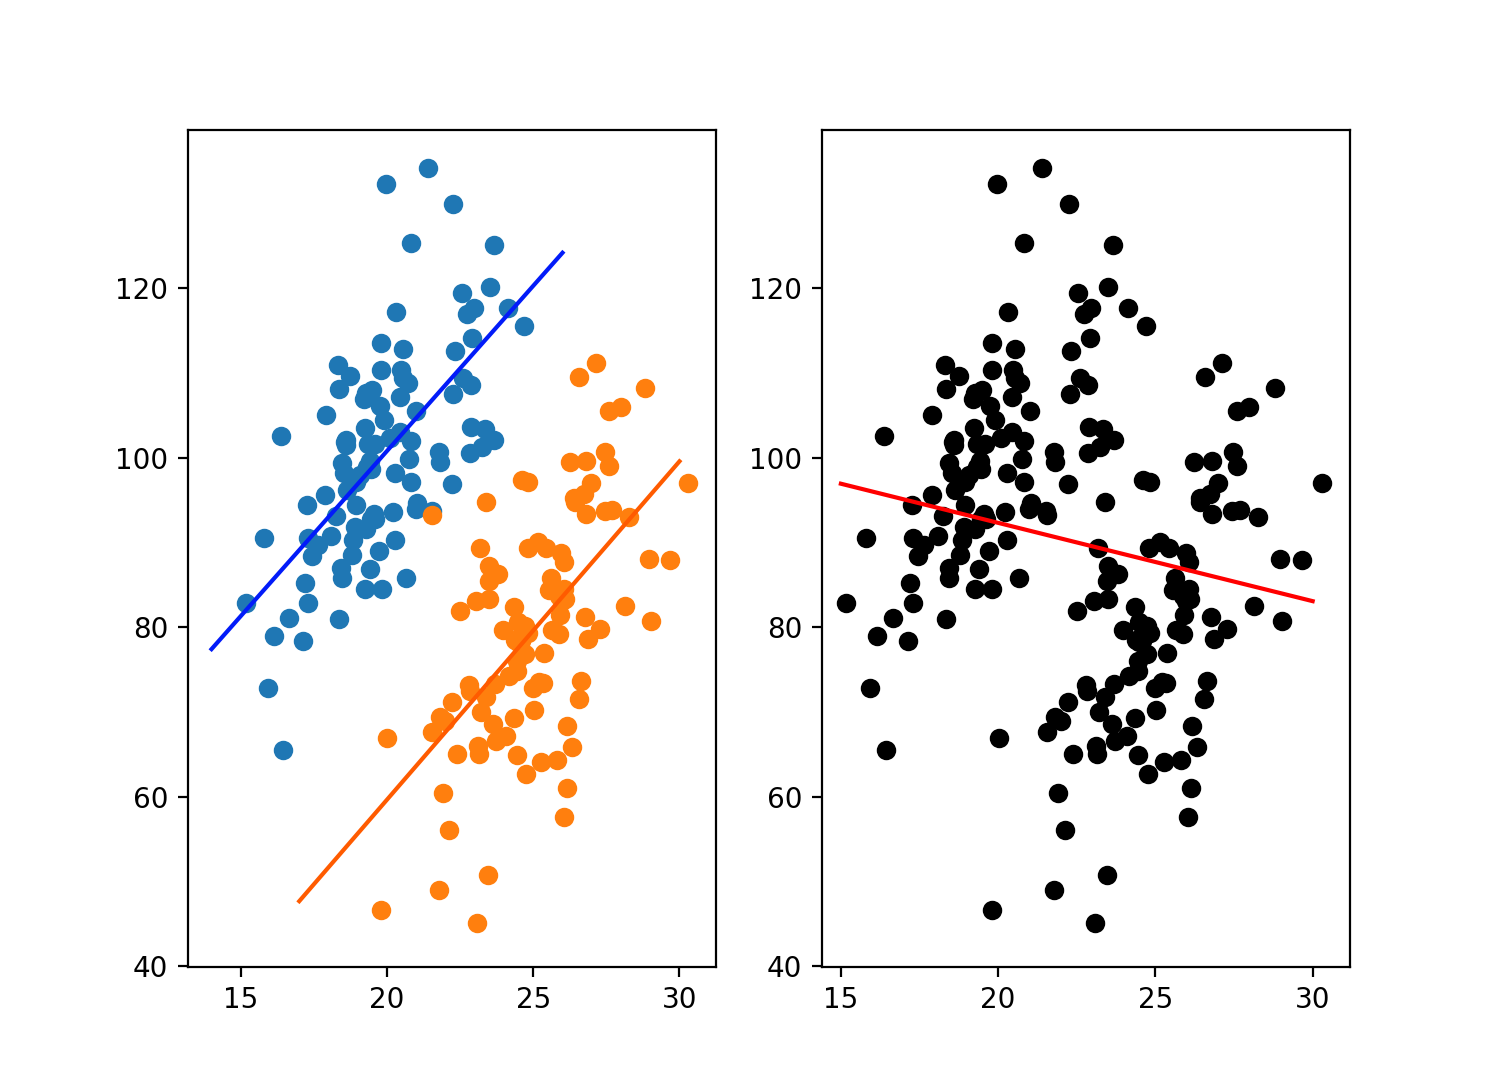
此外,条件概率和如下的统计推断现象也息息相关:
- 伪相关性, 例如冰淇凌的销量和游泳池事故率,亦或吸烟和肺癌。
- 潜变量导致的相关性,例如学生的数学成绩和艺术成绩
- 因果推断,当我们处理观察性研究时我们需要格外小心,推断因果关系时实验数据总是最有效的(虽然实验数据不一定容易得到)
条件期望
我们可以简单认为条件概率下的期望就是条件期望,在离散情形下E(Y∣X=x)=ΣyP(Y=y∣X=x),连续情形下E(Y∣X=x)=∫yP(Y=y∣X=x)dy。注意条件期望其实是一个随机变量,f(x)=E(Y∣X=x)→E(Y∣X)=f(x)
举一些特殊情况的条件期望的例子:
- E(X∣X)=X,E(X2∣X)=X2,E(X∣−X)=X
- E(Y∣X)=Y当且仅当Y是X的函数
- E(Y∣X)=E(Y)如果X和Y相互独立
条件期望的一系列性质包括:
- 线性:E(aY1+bY2∣X)=aE(Y1∣X)+bE(Y2∣X)
- 重叠期望:E(E(Y∣X))=E(Y)
- 单调性:Y1≤Y2,那么E(Y1∣X)≤E(Y2∣X)
条件概率的几何表示: 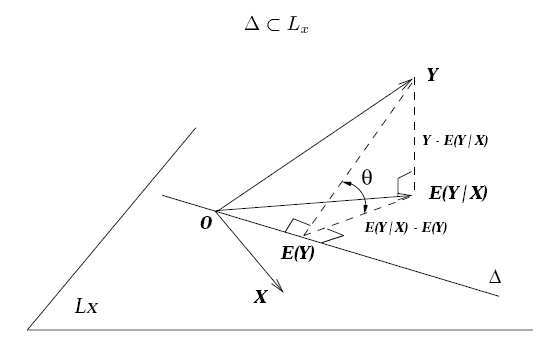
公式表述下:
- 勾股定理:E[Y2]=E[(Y−E(Y∣X))2]+E[E(Y∣X)2]
- 正交性:E[(Y−E(Y∣X))E(Y∣X)]=0
将勾股定理推广来讲:
- E[(Y−f(X))2]=E[(Y−E(Y∣X))2]+E[(E(Y∣X)−f(X))2]
- E[(Y−E(Y∣X))(E(Y∣X)−f(X))]=0,正交性可以推广成E[(Y−E(Y∣X))g(X)]=0
在所有预测中,条件期望是Y在X所在空间的最优预测E(Y∣X)=minf(X)E[(Y−f(X))2]
条件独立
在定义条件独立之前,我们可以看到有关条件独立的许多实例,比方说
- 有效市场假说:给定当前价格,任何其他信息都与资产的未来收益无关
- 马尔可夫性质:给定随机变量或随机过程的当前值, 未来的变化与过去无关
- 伪相关性:冰淇凌销量与游泳池溺水率
条件独立在数学上的定义是:离散情况下P(X=x,Y=y∣Z=z)=P(X=x∣Z=z)P(Y=y∣Z=z),连续情况下pX,Y∣Z(x,y∣z)=pX∣Z(x∣z)pY∣Z(y∣z),如果两个变量条件独立,那么E(XY∣Z)=E(X∣Z)E(Y∣Z)
条件独立常被运用于统计上,比如线性回归中的变量选择,Y=β1X1+β2X2+ϵ, Y与X2在X1条件独立,那么β2=0,也即E(Y∣X1,X2)=E(Y∣X1)
再比如多变量正态分布,零在Σ意味着边缘独立,零在Σ−1意味着条件独立,统计下的图模型正是利用条件独立的模型来研究因果推断和其他统计分析。
