人们研究赌博的最优下注问题已经有上百年的时间了,发表于1956年的Kelly公式给予了一个清晰的公式化答案,但它建立在人们需要完全了解赌博的结果分布的基础上。在量化投资领域,最优下注问题实际上就是风险配置问题,但投资结果的分布却不可能是事先已知的---人们顶多去预测它。这篇文章描述了我们如何使用几何布朗运动对连续情形中下注过程进行建模,从伊藤引理自然而然推导出一个连续情形下的Kelly公式。在此过程中我们需要先简单介绍随机微分方程。推导出的Kelly公式和我们熟悉的风险方差优化也有着有趣的关联。最后从投资者角度出发,这样一个理论模型在实际运用中还是有不少限制的。
引子
在很久以前人们已经开始研究如何在赌博时进行最优的下注,伯努利家族中的Daniel Bernoulli在1738年^1 的论文“Exposition of a New Theory on the Measurement of Risk”中研究了如何在一系列胜率和赔率不相同的赌博游戏中获得最优回报的那个游戏,他总结到,通过胜率和赔率计算出几何平均收益率最高的那款赌博游戏就是你该下注的那一个。John Kelly在1956年发表的“A New Interpretation of Information Rate”表达了类似的结论(以及更严密的证明细节),即你应当通过下注来最大化你的对数收益率,前提是你必须完全了解该赌博游戏的胜率分布。
假设在赌博游戏中胜率是p,赔率是b,下注比率是f,那么赌赢的概率是p, 此时财富总量为1+fb,赌输的概率是1−p,此时财富总量为1−f, 那么你的对数财富期望为Elog(wealth)=plog(1+fb)+(1−p)log(1−f), 为了最大化对数财富期望, 我们取其关于f的一阶导数bp/(1+f∗b)−(1−p)/(1−f∗)=0, 得到f∗=(p(1+b)−1)/b。这便是离散情形下的Kelly公式了,看上去简单明了易上手是吧,但真实情况并不乐观。
到了2016年,Haghani和Dewey在他们的论文“Rational Decision-Making under Uncertainty: Observed Betting patterns on a Biased Coin”中设计了一个简单的赌博游戏:
如果你被邀请参加一个猜硬币正反赌博游戏,你被事先告知硬币是有偏差的,掷出后会有60%的概率向上,你的初始资金是💲25并且可以持续下注30分钟, 你会怎么做呢?这就是我们对61位有过数理训练的年轻男女进行的一项实验。然而他们中的大多数没有合理地下注,而且体现出了各种行为和认知偏差。
简单总结一下Haghani和Dewey的实验:
-
实验设置:
- 共有61位参与者,其中大多数为大学生并且有专业金融背景。
- 硬币有0.6概率朝上这一信息已被告知于参与者,赔率是一赔二^2
-
实验结果
- 28%的参与者输光了所有资金
- 41位参与者至少猜了一次硬币向下,13位参与者至少在25%的情况下猜了硬币向下
- 有些参与者一直猜测硬币向下直到输光所有资金
是不是有点难以置信?这些可是受过严格数理训练的大学生,在参与一个有明显优势的赌博游戏中竟然有超过四分之一的人输光了本金,有超过三分之二的人走向了概率的反面(否则不会猜测硬币向下)。而那些一直猜测硬币向下的参与者,常规的理性已经无法解释他们的行为了,可能他们的思维被阴谋论主导以至于不相信有如此天上掉馅饼的事吧。
随机微分简介
为了将最优下注问题转化为量化投资领域中的风险分析,我们需要先来聊聊随机微分,假设Xt是一个时间序列,纳闷我们都知道关于Xt的常微分方程(ODE):
dXt=a(Xt)dt
而相对应的随机微分方程(SDE)就是在常微分方程解的基础上加一个随机项:
dXt=a(Xt)dt+b(Xt)dWt
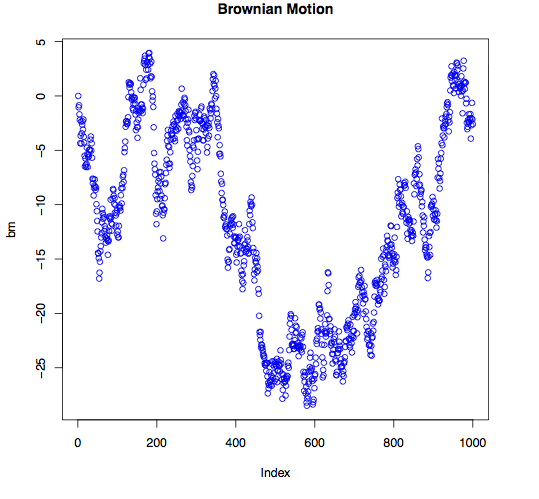
Wt便是随机的由来,它有自己的定义— 布朗运动,Wt有着一系列数学性质:
- W0=0
- Wt是连续的
- Wt各点之间的差值相互独立
- Wt−Ws~N(0,t−s)
接下来我们引入泰勒展开:
df(Xt)=f(Xt+dXt)−f(Xt)=f′(Xt)dXt+1/2f′′(Xt)(dXt)2+...
带入常微分方程:
df(Xt)=f′(Xt)a(Xt)dt+1/2f′′(Xt)a2(Xt)dt2+...
带入随机微分方程:
df(Xt)=f′(Xt)[a(Xt)dt+b(Xt)dWt]+1/2f′′(Xt)[a2(Xt)dt2+2a(Xt)b(Xt)dtdWt+b2(Xt)(dWt)2]+...
=f′(Xt)[a(Xt)dt+b(Xt)dWt]+1/2f′′(Xt)b2(Xt)dt
这就是大名鼎鼎的伊藤引理(Ito’s lemma)
伊藤引理说的就是带入Xt的随机微分方程的解时df(Xt)的泰勒(一阶)展开:df(Xt)=f′(Xt)[a(Xt)dt+b(Xt)dWt]+1/2f′′(Xt)b2(Xt)dt
我们来看一个具体的例子,假设我们有一个按固定比率复合增长的时间序列Xt,Xt满足如下的常微分方程:
dXt=μXtdt
如果我们在这个时间序列上加上随机白噪声(通常用来模拟资产价格的时间序列),那么Xt将满足如下的随机微分方程:
dXt=μXtdt+σXtdWt

dlog(Xt)=1/XtμXtdt=μdt
两边取积分,得到:
log(Xt)−log(Xs)=μ(t−s),orXt=X0exp(μt)
同时在随机微分方程形式下,我们利用伊藤引理得到的结果变得很有意思:
dlog(Xt)=1/Xt(μXtdt+σXtdWt)−1/(2Xt2)σ2Xt2dt=(μσ2/2)dt+σdWt
两边取积分,故而:
log(Xt)−log(Xs)=(μ−σ2/2)(t−s)+σ(Wt−Ws)
综上所述,随机微分方程dXt=μXtdt+σXtdWt的解满足log(Xt/Xs)~N((μ−σ2/2)(t−s),σ2(t−s)),此时Xt被称作几何布朗运动(Geometric Brownian Motion (GBM))。
GBM有如下的应用:
- GBM可以用来对带噪声的连续复合收益序列建模
- GBM通常用来描述资产价格走势
- GBM描述下的资产对数收益是正态分布的
我们继续扩展上述的具体例子,假设我们有Ct的总资本去投资,我们拿出总资本的k部分去投资之前的资产(其价格序列为Xt),进一步假设我们将收益或亏损进行连续再投资,那么
dCt=kCt(dXt/Xt)=kμCtdt+kσCtdWt
这恰恰是含有不同参数的又一个GBM。所以之前的最优下注问题转化为了我们应该如何选取k,更细分地说:
- 如果0<=k<=1,那么我们会买入价值kCt的资产X
- 如果k>1,这时我们需要杠杆,先借贷(k−1)Ct, 然后买入价值kCt的资产X
连续情形下的Kelly公式
投资即下注,我们所熟知的Kelly公式描述的是在离散情况下的最优下注比率,我们可以从随机微分方程的角度来分析连续情况下的最优下注比率。 根据上一节GBM的性质,我们知道投入带杠杆的资金后的资本累积收益满足:
log(Ct/C0)~N((kμ−k2σ2/2)t,k2σ2t)
因此资金投入的单位时间对数收益为:
E[log(Ct/C0)/t]=kμ−k2σ2/2
此时最优下注比率k已经呼之欲出,我们只需要令上述期望的一阶导数为零从而得出:
k=μ/σ2
当投资者需要投资于一个价格序列满足随机布朗运动的资产时,Kelly公式表明当下注比率为k=μ/σ2 时单位时间内的对数收益期望最大。
现在我们把格局放大一点,从单一资产推广到多个资产的情形。假设我们有p个资产且他们的价格序列都符合几何布朗运动,Xt=(Xt(1),...Xt(p))T∈Rp
与此同时
k=(k1,…kp)T,μ=(μ1,…μp),σ=(σ1,…σp).
假设:
dXt=diag(μ)Xtdt+diag(σ)XtdVt
其中Vt是满足dVt~N(0,Rdt)的p维布朗运动,R是p×p的相关性矩阵。
现在我们在资产X(i) 上投入资金kiCt,其中i=1,…p。同时所有的收益/亏损会被再投资到整个资金池Ct中,那么:
dCt=∑i=1pkiCtdXt(i)/Xt(i)
dCt/Ct=∑ikidXt(i)/Xt(i)
=(kμ)dt+∑ikiσidVi
∼(kμ)dt+√(kTΣk)dWt∗ 其中Σ=(diag(σ))R(diag(σ))
从而得到:E[log(Ct/C0)/t]=kμ−kTΣk/2^3
当投资者需要投资于多个价格序列满足p维随机布朗运动的资产时,Kelly公式表明当下注比率为k=μΣ−1 时单位时间内的对数收益期望最大。
接下来我们用大白话总结一下使用k比率投资不同资产的结果
| kμ |
kμ−kTΣk |
长期结果 |
| >0 |
>0 |
别墅靠海 |
| <=0 |
|
天台排队 |
| >0 |
<=0 |
天台排队 |
我们重点来看第三种情况,即当k∙μ>0,而k∙μ−kTΣk<=0时,此时
E[Ct]=C0(k∙μ)t→∞,同时Ct→p0
看着很拗口,这是在说你的投资收益期望会渐近增加到无穷大,但你的资本达到该收益期望的可能会依概率收敛到0。具体点说就是投资收益的分布会有一个有着无限长的负值肥尾和无限高峰值的形状,你的期望值是无穷大,但你的收益分布点几乎一定会落在肥尾上的某个负值处。
一个例子
假设我们有两项待投资资产:
- S&P500指数(SPY)
- 长期债券指数(VBLTX)
他们的价格走势如下:
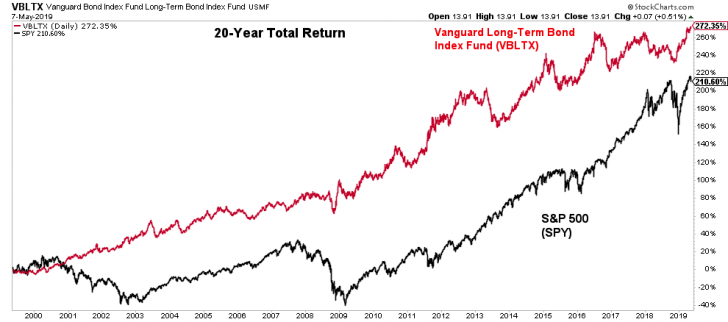
根据历史数据,我们可以直接估计
μ=(μVBLTX,μSPY)T
Σ=[σVBLTX2ρσVBLTXσSPYρσVBLTXσSPYσSPY2]
然后使用Kelly公式求出最优下注比率向量k。
比方说从近五年看,μ^=(0.00016,0.00052)T, ρ^=−0.33,σ^VBLTX=0.0060,σ^SPY=0.0077
那么我们可以推出:k≃[9.0,11.1]T
从近十二年看(囊括次贷危机时期),μ^=(0.00029,0.00029)T, ρ^=−0.38,σ^VBLTX=0.0070,σ^SPY=0.0129
那么我们可以推出:k≃[8.3,3.4]T
[8.3,3.4]代表着我们需要杠杆:
- 假设我们初始资金C0=💲100K,我们需要借贷💲1.07M,然后一共投资💲1.17M
- 在每个交易日我们要:
- 结算收益/亏损
- 根据需要借入或返还资金
- 再平衡投资比率
Kelly公式与均值方差优化
我们已经知道当你投资于一个价格符合几何布朗运动的资产时,你的资金增长为dCt=kCt(dXt/Xt),为了最大化你的单位时间内对数收益,此时你的最优下注比率k∗=μ/σ2
现在我们来考虑另一个问题,即如何优化你的仓位配置,从而使得你的收益方差效用函数最大化:
p∗=argmax{pμ−λp2σ2/2},那么p∗=μ/λσ2,同时我们可知仓位无非是资金和下注比率的乘积p∗=k∗Ct,由此得到μ/λσ2=k∗Ct=μCt/σ2↔︎λ=1/Ct
于是我们建立了Kelly公式和均值方差优化的链接
如果你拥有💲C的资金待投,那么当你在优化均值方差效用函数中设定风险厌恶系数λ=1/C时,你的单位时间内对数收益期望可以同时达到最大化
如果你在风险厌恶系数λ<1/(2C) 时优化均值方差效用函数,你将陷入前一节提到的第三种情形(天台排队😂)
总结一下
- 我们通过推导伊藤引理建立资产价格的几何布朗运动模型,进而推导出连续情形下的Kelly公式
- Kelly公式可以用来说明均值方差优化的合理性
- 但由于如下的现实原因,Kelly公式所得的下注比率k并不被推荐在实操中使用
- 资产收益的肥尾分布
- 资产价格的随机跳动
- 资产间的异质性
- 模型参数的不确定性
